6GB 显存跑 35B MoE?真正撑场的是 64GB 内存
在系统内存充足的条件下,6 GB 显存可以支持 35B 级 MoE 模型达到实际可用状态。
测试平台:NVIDIA RTX 3060 Laptop GPU(6 GB VRAM)· 模型:Qwen3.6-35B-A3B(4-bit 混合精度)
1. 研究问题与主要结论
本研究考察的问题是:在显存容量为 6 GB 的消费级移动端 GPU 上,参数规模为 35B 的混合专家(MoE)模型能否达到实际可用状态;若可以,其瓶颈位于显存容量、 KV Cache、系统内存还是推理吞吐。
实验结果表明,在系统内存为 64 GB 的条件下,该模型可以稳定运行:
| 指标 | 观测值 |
|---|---|
| 显存占用峰值 | 2825 MiB(其中模型自身 2816 MiB,约占可用显存的 46%) |
| 文本生成速率 | 约 25.6 tokens/s(5 次重复,25.0–26.3) |
| 输入处理速率 | 约 307 tokens/s(5 次重复,291–319) |
上表取自 5 次独立重复运行(REP-101..REP-105)。同一配置在上午的会话中测得 21.49 与 22.92 tokens/s,相差约 15%、区间不重叠 —— 时段间漂移大于时段内波动,跨会话速率不可直接比较。口径见第 10 节。
达成该结果所需的推理参数配置为:
llama-bench -m Qwen3.6-35B-A3B-UD-Q4_K_XL.gguf \
  -ngl 99 \        # 非专家层全部卸载至 GPU
  -ncmoe 40 \      # 全部 40 层的专家权重保留于系统内存
  -p 512 -n 128 -r 5 -o json
该结果的前提条件需予明确:MoE 架构的专家权重可完整驻留于系统内存,显存仅需容纳注意力层、路由层与 KV Cache。
上述结论依赖测试平台 64 GB 的系统内存。20.8 GiB 的模型文件以 page cache 形式驻留于内存,显存仅承担每步推理中反复访问的部分。在系统内存为 16 GB 的设备上,该结论不成立,需先核算内存预算。
2. 测试环境
| 项目 | 配置 |
|---|---|
| GPU | RTX 3060 Laptop GPU,6 GB,compute capability 8.6 |
| CPU | Intel Core i7-12700H,14 核 20 线程 |
| 系统内存 | 64 GB DDR5-5200,双通道 |
| 操作系统 | Windows 11,推理运行于 WSL2(Ubuntu 24.04) |
| 推理框架 | llama.cpp,commit 9655061 |
| CUDA | 12.8,CMAKE_CUDA_ARCHITECTURES=86 |
被测模型为 Qwen3.6-35B-A3B 的 4-bit 混合精度量化版本,文件大小 20.8 GiB, SHA256 校验值 707a55a8…4450。模型结构参数如下:总参数量 35B,激活参数量约 3B;共 40 层,每层 256 个专家,每个 token 激活 8 个,激活比例约 3.1%;原生上下文长度 262144 tokens。
关于量化命名的说明。模型元数据中
general.file_type声明的值为 15 (约对应 MOSTLY_Q4_K_M),但实测张量类型分布为 Q4_K 10.6%、Q5_K 5.2%、 Q6_K 0.5%、Q8_0 34.4%、F32 49.2%,属 Unsloth Dynamic 系列的混合精度方案。 元数据中的声明值并非文件内容的证明。按照 "Q4_K_M" 检索下载所得到的文件, 与本研究所测文件并非同一对象。文献引用时应给出仓库、文件名与校验值。
关于硬件型号。RTX 3060 的移动版显存为 6 GB,桌面版为 12 GB 或 8 GB,两者不属于同一设备,测试结果不可相互引用。
3. 变量一:MoE 专家权重的驻留位置
本研究的第一条主轴为专家权重在 GPU 与 CPU 之间的分配。固定 -ngl 99(非专家层全部卸载至 GPU),扫描 -ncmoe 参数:
| run_id | 专家层驻留 CPU | 输入处理 (t/s) | 文本生成 (t/s) | 运行时长 | 显存峰值 |
|---|---|---|---|---|---|
MOE-001 |
0(全部驻留 GPU) | 79.5 | 5.16 | 192 s | 5940 MiB |
MOE-002 |
10 | 81.3 | 6.66 | 141 s | 5962 MiB |
MOE-003 |
20 | 75.4 | 9.32 | 116 s | 5972 MiB |
MOE-004 |
30 | 94.8 | 16.27 | 76 s | 5978 MiB |
MOE-005 |
40(全部驻留 CPU) | 302.8 | 21.49 | 43 s | 2860 MiB |
将专家权重全部移出 GPU 后,文本生成速率提升 4.2 倍,显存占用下降约 52%。
该结果与"尽可能减少 CPU 卸载"的一般经验相反。其机制在于:当 20.8 GiB 的权重被分配给容量为 6 GiB 的显存时,超出部分需通过 PCIe 总线反复访问,每一 token 的解码过程都受限于 PCIe 传输。将专家权重完整移回系统内存后,显存侧的访问模式恢复为常规状态。
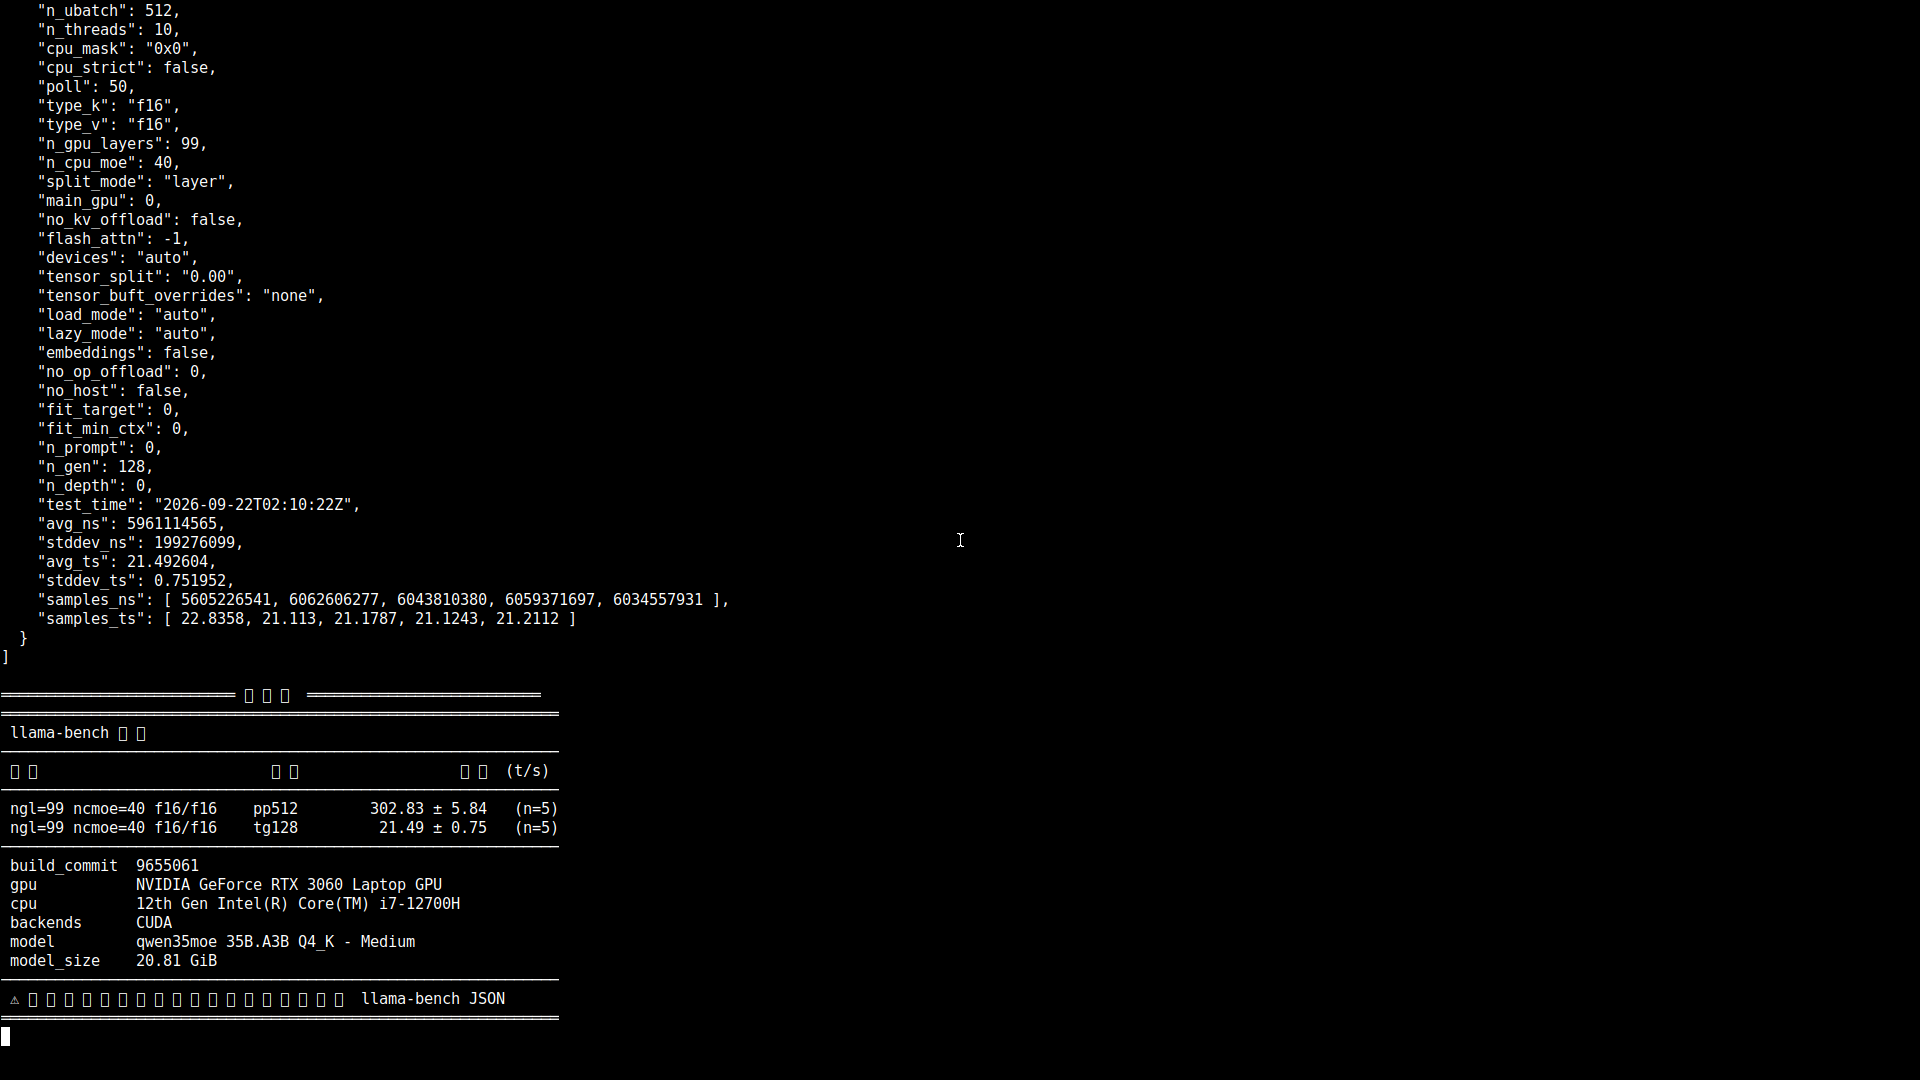
-ngl 99 -ncmoe 40)条件下的测试结果。 显存占用峰值 2860 MiB。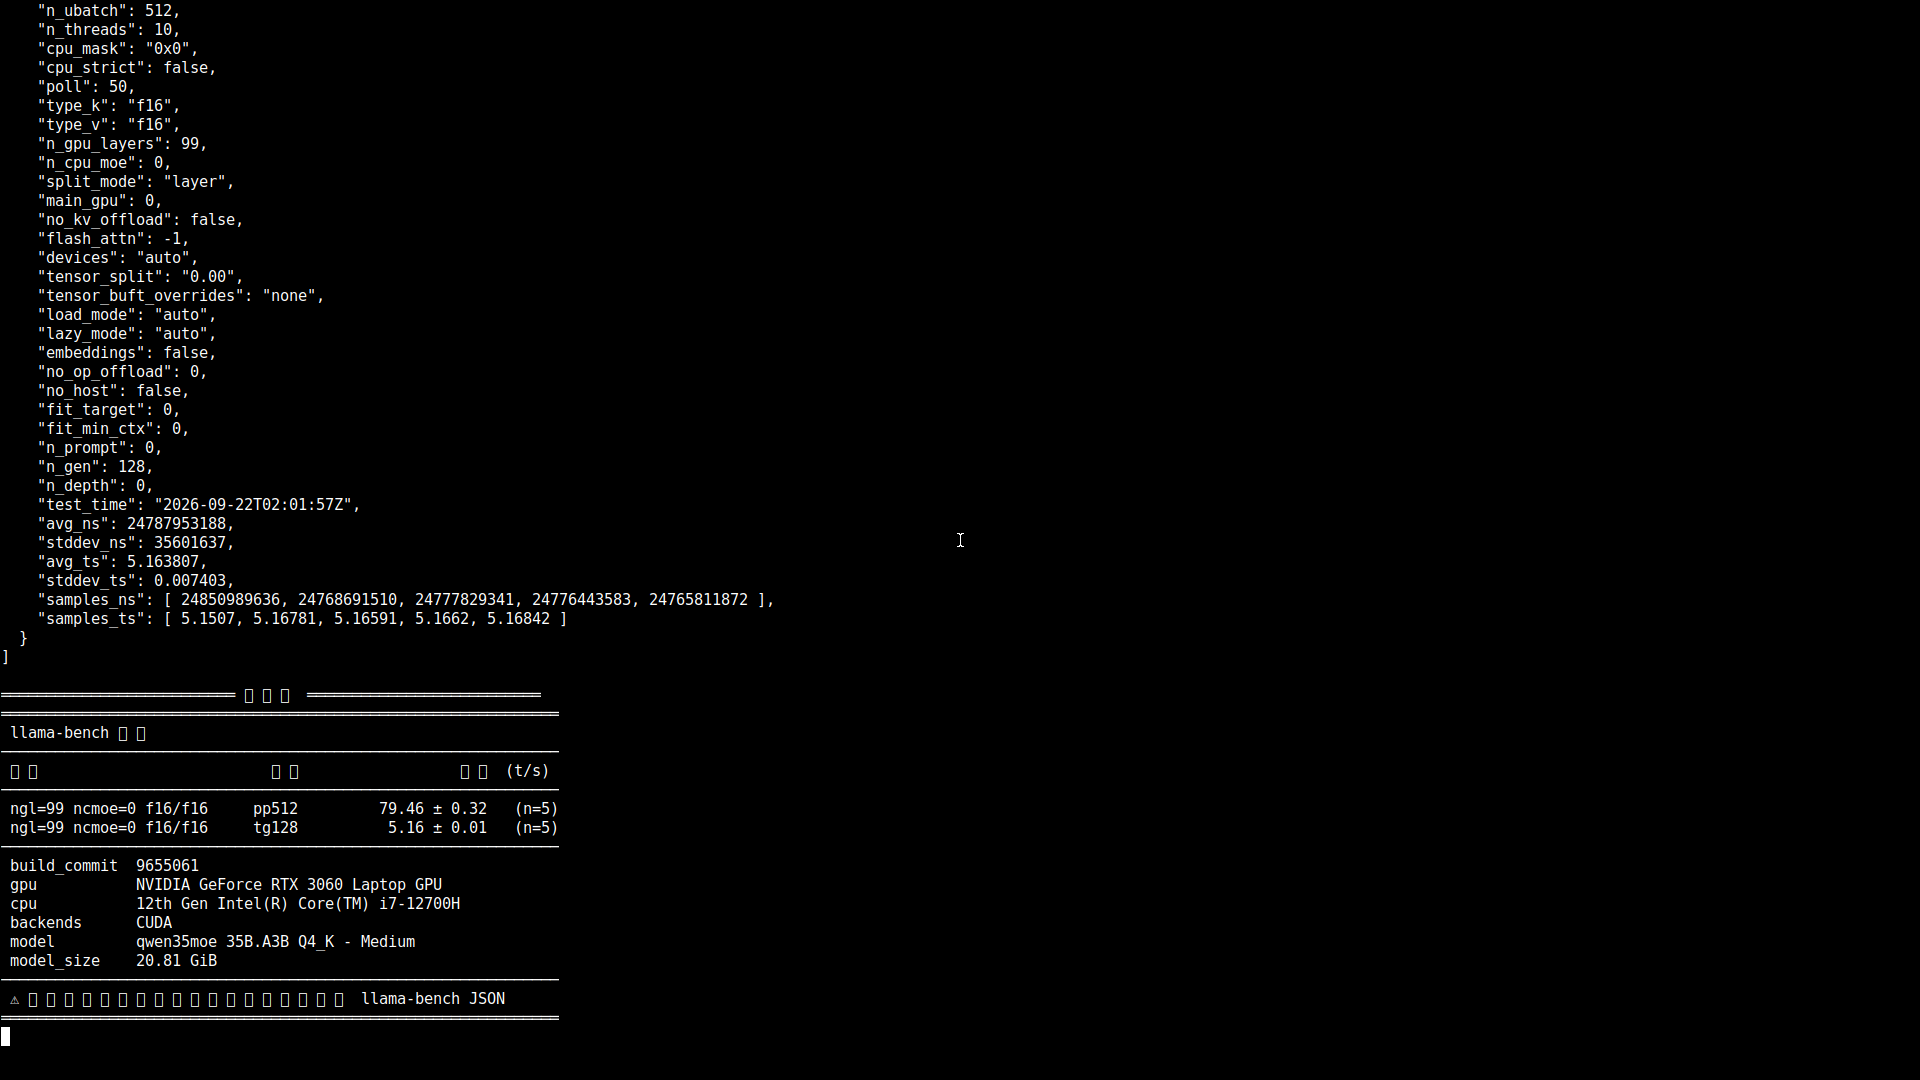
-ncmoe 0)条件下的测试结果。 文本生成速率 5.16 tokens/s,显存占用峰值 5940 MiB。修订记录(2026-09-22 二编)
本条结论的稳健性较高。4.2 倍的差异显著超出测量噪声,而同一配置的重复运行 波动约为 5%(见第 10 节)。
但中间档位的差异不足以支持结论。
-ncmoe 10与20的输入处理速率低于-ncmoe 0,呈非单调关系;差异幅度为 5% 至 8%,位于测量噪声范围内。 就现有数据而言,只能判断这些档位"未表现出速率提升", 不足以判断其"导致速率下降"。
4. 变量二:非专家层的卸载层数
固定专家权重全部驻留 CPU(-ncmoe 40),扫描 -ngl 参数:
| run_id | ngl | 输入处理 (t/s) | 文本生成 (t/s) | 显存峰值 |
|---|---|---|---|---|
BASE-001 |
0 | 237.3 | 8.85 | 1318 MiB |
BASE-002 |
10 | 242.8 | 8.50 | 2010 MiB |
BASE-003 |
20 | 270.7 | 11.47 | 2406 MiB |
BASE-004 |
30 | 279.2 | 14.44 | 2776 MiB |
BASE-005 |
99 | 305.6 | 22.92 | 2860 MiB |
-ngl 10 的文本生成速率低于 -ngl 0。部分卸载引入了 PCIe 传输开销,其代价超过 GPU 计算带来的收益。卸载层数的选择因此存在阈值效应:不足量的卸载不如不卸载。
5. 变量三:上下文长度上限
固定 -ngl 99 -ncmoe 40,改变上下文深度:
| run_id | 上下文深度 | 输入处理 (t/s) | 文本生成 (t/s) | 显存峰值 |
|---|---|---|---|---|
CTX-001 |
4096 | 304.8 | 22.16 | 2960 MiB |
CTX-002 |
8192 | 291.9 | 21.46 | 3042 MiB |
CTX-003 |
16384 | 274.7 | 20.56 | 3540 MiB |
CTX-004 |
32768 | 277.2 | 16.78 ± 6.83 | 5985 MiB |
CTX-005 |
65536 | 235.6 | 20.41 | 5988 MiB |
上下文长度 65536 可以完成加载与推理。但该结果需附加限定:
显存占用在 32768 即达到平台期,峰值为 5985 MiB,占显卡可用显存的 97.5%; 65536 条件下的峰值为 5988 MiB,与前者基本相同。此外,32768 档位的文本生成速率标准差为 ±6.83,显著高于其他档位(均低于 ±1.2),表明该条件下的运行状态不稳定。
对 64K 结果的准确表述应为:模型可完成加载、可完成推理、在召回测试中亦通过, 但显存已无剩余容量。不宜表述为"64K 可无压力运行"。
被测模型的声明上下文长度为 262144 tokens。本研究覆盖范围不超过其四分之一, 相关结论仅限于 65536 tokens 以内。
6. 变量四:KV Cache 量化
6.1 初步设计及其失败原因
初步实验在 llama-bench 默认上下文深度下比较三种 KV 精度:
| run_id | KV 精度 | 显存峰值 |
|---|---|---|
KV-001 |
f16 | 2860 MiB |
KV-002 |
q8_0 | 2856 MiB |
KV-003 |
q4_0 | 2854 MiB |
三组结果的显存占用差异为 6 MiB,未观察到有效差异。
该结果源于实验设计缺陷。
llama-bench的默认上下文深度约为 640 tokens, 此规模下 KV Cache 占用量可忽略,量化对显存的影响无法体现。 评估 KV 量化的显存收益,必须在长上下文条件下进行。
6.2 在 16384 上下文深度下的重测
在 16384 上下文深度下重新比较:
| run_id | KV 精度 | 输入处理 (t/s) | 文本生成 (t/s) | 显存峰值 | 相对 f16 |
|---|---|---|---|---|---|
KV-101 |
f16 | 260.5 | 20.58 | 3540 MiB | — |
KV-102 |
q8_0 | 274.1 | 19.91 | 3048 MiB | 减少 492 MiB |
KV-103 |
q4_0 | 263.6 | 19.69 | 2966 MiB | 减少 574 MiB |
f16 至 q4_0 的显存节省为 574 MiB。该数值属确定性结果 —— 显存分配由张量尺寸计算决定,不受运行波动影响。同一组配置在另一独立批次中测得的三档峰值完全相同(3540 / 3048 / 2966 MiB),印证了这一点。
需要指出,在本研究的配置条件下,KV 量化并非瓶颈。专家权重已驻留系统内存,显存占用为 2.8 GiB / 6 GiB,节省的容量未转化为实际收益。该优化仅当需要将更多层重新卸载至 GPU 时才有意义;而第 4 节的数据表明,该方向并不经济。
7. 长上下文检索能力测试
本节采用长上下文检索的标准方法评估模型在长文本中的信息提取能力。测试构造方式为:将一条随机生成的标识符插入长文本的不同相对位置,随后要求模型返回该标识符。方法上对应于 RULER 基准中的单针检索任务(S-NIAH)。
测试集版本为 longcontext-v1(26 题,中英各半),由 tools/gen-longcontext.py
在固定随机种子下生成,题目与判定标准随本节结论一并公开。以下为 run 1 的结果。
各长度与插入深度条件下的正确率如下:
| 文本长度 | 起始位置 | 中间位置 | 末尾位置 | PRV |
|---|---|---|---|---|
| 4096 | 100% | 100% | 100% | 0.0% |
| 16384 | 100% | 100% | 50% | 23.6% |
| 65536 | 100% | 100% | 100% | 0.0% |
扩展任务类别的结果如下:
| 任务类别 | 正确率 |
|---|---|
| 单针检索 | 94.4% |
| 多针检索(返回全部 3 条) | 100% |
| 多跳变量追踪 | 100% |
| 干扰项区分(插入 3 条相似假标识符) | 50% |
| 高频词聚合 | 0% |
本组结果需附加三项限定:
其一,测试文本为合成语料。已有研究指出,合成基准会系统性高估真实场景表现, 幅度约为 20% 至 40%(生态效度比通常为 0.6 至 0.8)。本结果不足以支持 "真实场景同样可用"的推论。
其二,每个单元格仅含 2 个样本(中文与英文各一)。50% 的正确率对应 两题中一题失败,分辨率较低,不宜作精细解读。
其三,测试范围止于 65536 tokens。被测模型原生上下文为 262144 tokens, 本研究结果不可与更长上下文的同类研究直接对比。
7.1 观察到的失效模式:枚举失焦
在 3 个测试样本中,模型未返回答案,而是持续列举文本中出现的词汇,直至耗尽生成配额。最长的一次连续输出为 13419 字符。将生成上限由 1536 tokens 提高至 4096 tokens 后,该现象依旧出现。
此类失效不同于答案错误。其表现为推理过程无法收敛至结论。
8. 任务能力评估
推理吞吐量不足以刻画模型的可用性。在同一平台上,本研究另设 5 项任务能力测试。
| 测试项 | 判定 | 结果摘要 |
|---|---|---|
| SVG 动画生成(鹈鹕骑自行车) | 部分通过 | 腿部与车轮均可运动,动画循环完整;但大腿关节随整条腿转动 |
| WebGL 场景生成(黑洞,多轮) | 通过 | 首版主渲染区无输出;经一轮反馈后自行修复 |
| UI 组件生成(iOS 天气卡片) | 未通过 | 页面仅显示标题,四张卡片均未渲染 |
| 逻辑推理(糖果计数) | 未通过 | 输出 29,正确结果为 21 |
| 逻辑推理(遗传关系) | 未通过 | 推理过程排除唯一正确路径 |
判定依据为 01-实验/testsets/capability-v1/rubric.md 所定义的三级标准(通过 / 部分通过 / 未通过)。判定过程基于对渲染结果的人工观察,未采用模型自评。
8.1 SVG 动画生成
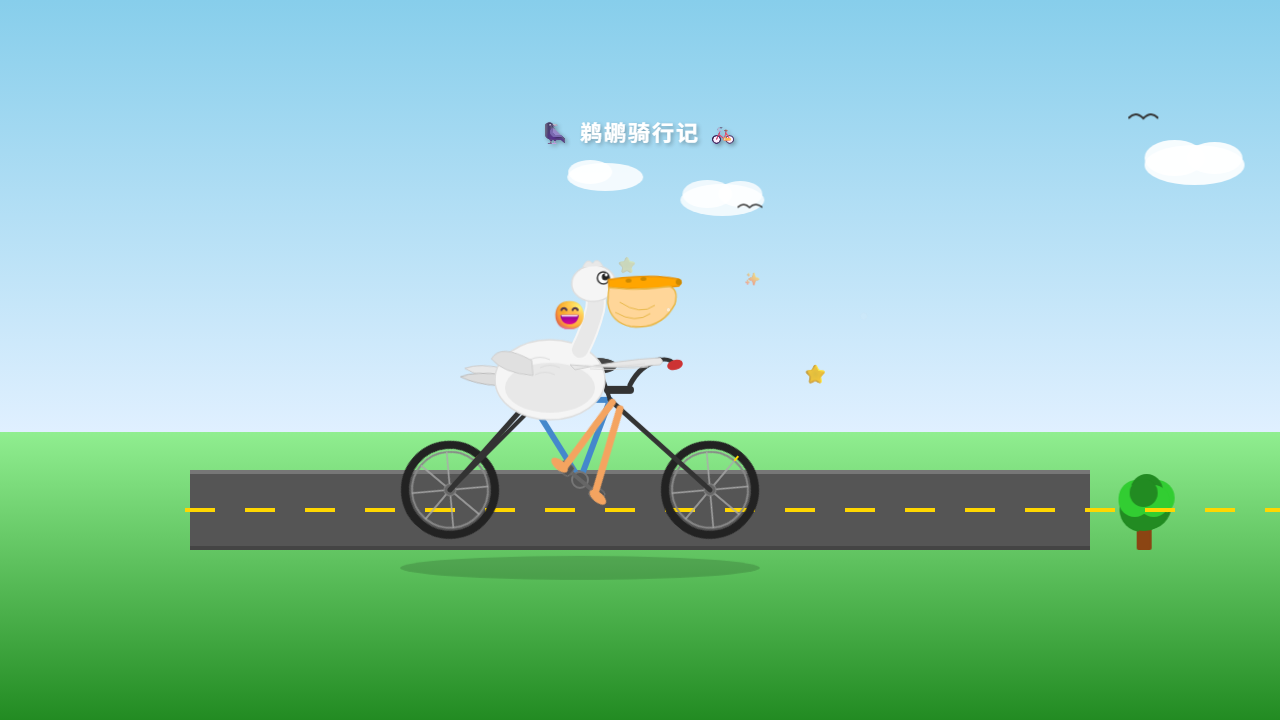
该项判为部分通过,原因在于腿部运动学处理不完整。
正确的腿部反向运动学(Inverse Kinematics)应满足:大腿角度基本固定, 小腿绕膝关节摆动,使足端持续贴合踏板。模型实际采用的方式是将整条腿 作为刚体旋转,缺少膝关节的独立自由度。
外显行为上表现为"腿部在动",但运动学结构不正确。 该缺陷可复现、可描述,其信息量高于二元的通过与否判定。
8.2 WebGL 场景生成及其多轮修复
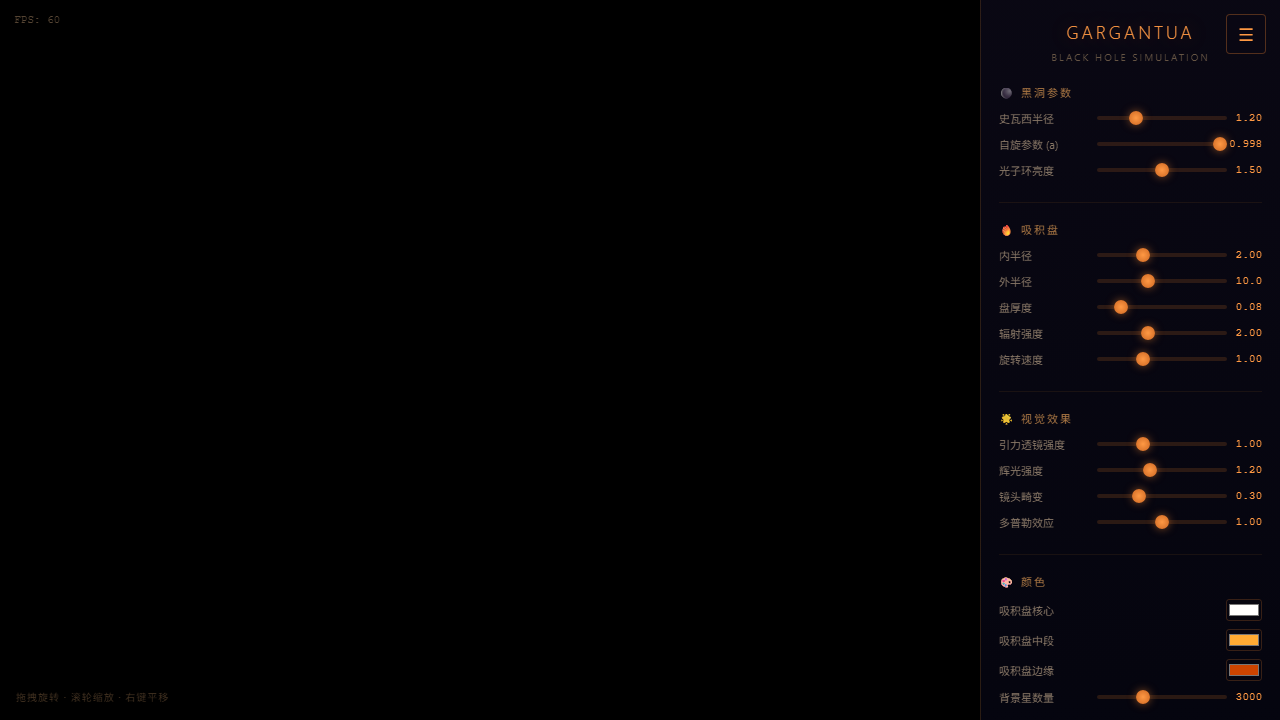
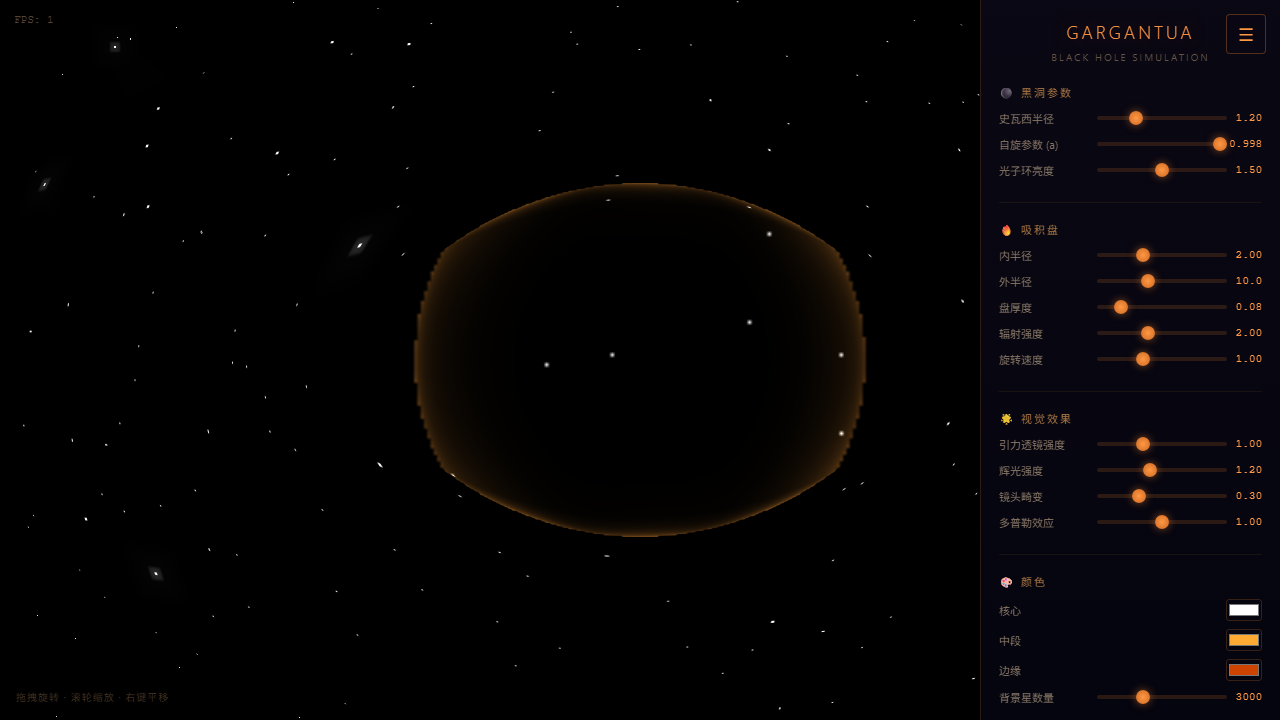
本项测试的考察目标是多轮自我修复能力,因此首版失败是测试设计的组成部分, 须在结果中如实呈现,不宜仅报告修复后的状态。
另需记录:渲染画面左下角显示帧率为 1 FPS。代码本身可运行, 但该平台无法提供可用的渲染性能。代码正确性与运行性能是两个独立指标。
8.3 UI 组件生成:代码完备性与运行可用性的背离
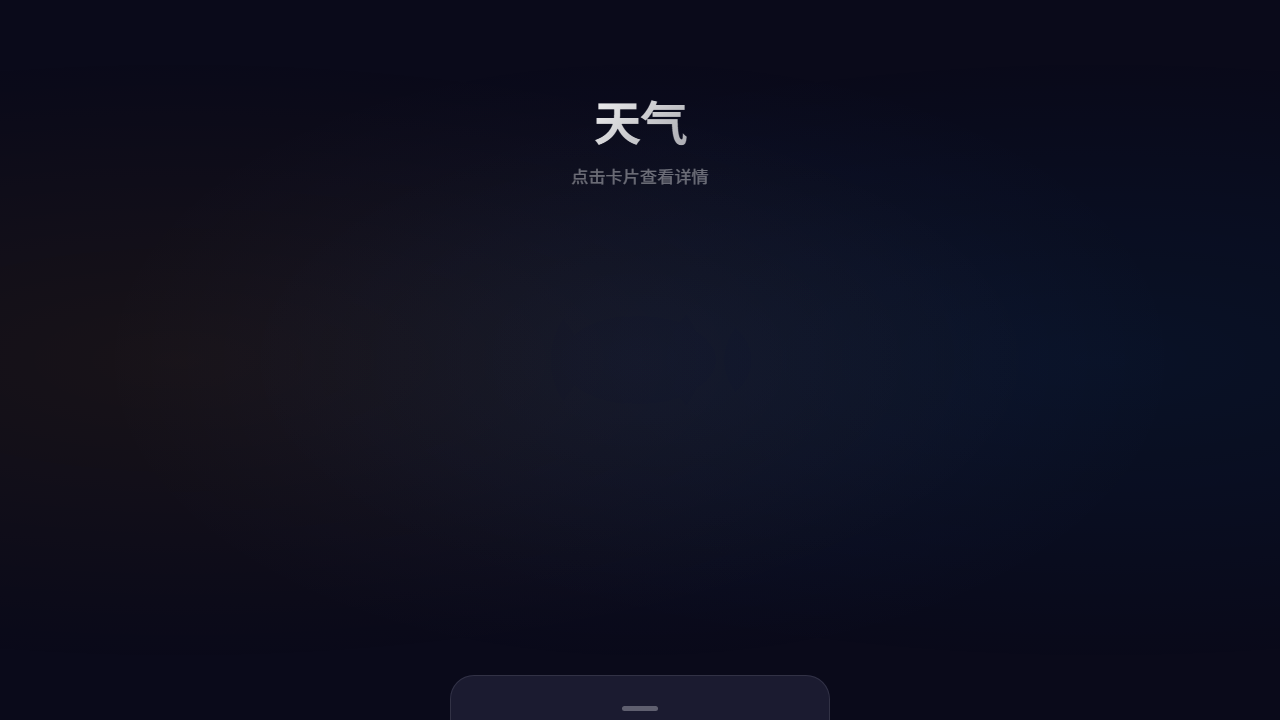
该输出文件的代码构成包含 4 组卡片元素(
card-bg、card-content、card-desc、card-location、card-meta)与 10 个动画关键帧 (太阳脉冲、降雨、降雪、风场、云漂移、卡片入场等)。而实际渲染结果为无有效内容。
若依据代码规模或由生成模型自评完成度,将得到与实际相反的结论。 该项评估必须基于实际渲染输出。
8.4 逻辑推理
糖果计数题输出 29,正确结果为 21。
遗传关系题的推理过程达 465 行,最终结论排除了唯一正确路径:
Alternative Answer Check: …
So Father is not colorblind.
So this path is dead.
正确答案恰为"父亲为红绿色盲"。在全部推理文本中,未出现"色盲"或"遗传"字样。
该样本表明,推理长度与推理正确性之间无必然关联。
9. 部署方法
# 编译环境(WSL2 / Ubuntu 24.04)
cmake -S . -B build -G Ninja \
  -DCMAKE_BUILD_TYPE=Release \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=86      # RTX 3060 Laptop 的 compute capability 为 8.6

cmake --build build --target llama-server llama-cli llama-bench -j $(nproc)
对应本研究结论的启动参数及说明:
./build/bin/llama-server \
  -m Qwen3.6-35B-A3B-UD-Q4_K_XL.gguf \  # 模型路径
  -c 65536 \                      # 上下文长度;实测上限,显存将占满
  -ngl 99 \                       # 卸载至 GPU 的层数,取最大值
  -ncmoe 40 \                     # 专家权重驻留 CPU 的层数,本研究核心参数
  -ctk f16 -ctv f16 \             # KV 精度;16384 上下文下 q4_0 可节省 574 MiB
  -fa on \                        # 启用快速注意力
  --no-mmap \                     # 禁用内存映射,模型直接驻留内存
  -np 1 \                         # 单并发
  --host 0.0.0.0 --port 18080
关于
-ncmoe:该参数定义驻留于 CPU 的 MoE 专家层数量, 与-ngl(卸载至 GPU 的层数)分属两个独立维度。调参时应固定其中一者, 扫描另一者。本研究采用此方式。关于
-ctk/-ctv:参考教程指出量化 V Cache 需要启用-fa。 在 commit 9655061 上实测无需该参数亦可正常运行。该行为与版本相关, 升级框架后需重新验证。
10. 测量方法与口径说明
本节说明本研究数据的采集方式与适用范围,以便结果的复现与引用。
第一,全部数值取自单次运行的原始输出文件,未从界面截图中读取。截图仅用于说明操作的视觉过程。
第二,显存占用与推理速率具有不同的可复现性;而速率的波动量级又取决于 在多大范围内比较,两者必须分开陈述。
显存占用属确定性结果。 模型自身占用 = 峰值 − 空闲基线:7 次独立运行(MOE-005、BASE-005、REP-101..REP-105)均为 2816 MiB,完全一致。绝对峰值随空闲基线变化(9 MiB 时 2825 MiB,44 MiB 时 2860 MiB),引用需注明口径。
速率不是确定性结果,且分组之间差异显著:
| 比较范围 | 样本 | 文本生成速率 | 极差 |
|---|---|---|---|
| 同一时段内(傍晚会话) | 5 次独立运行 REP-101..REP-105 |
25.01 – 26.32 tokens/s | 5.1% |
| 跨时段(与上午会话比) | 上午 2 次 MOE-005、BASE-005 |
21.49、22.92 tokens/s | — |
上午会话与傍晚会话的均值分别为 22.2 与 25.6 tokens/s,相差约 15%,两组区间完全不重叠。配置、模型与 llama.cpp commit 均相同,差异来自测量时段本身(同类设备上的时段间漂移)。
据此,引用建议为:同一批次内比较配置时(第 3 至第 6 节的扫描表均为同批连续运行),5% 以内不足以判断优劣;跨批次的速率不可直接比较 —— 漂移约 15%,已超过多数配置差异本身。
第三,llama-bench 的计时不包含分词与采样开销,其数值不等同于端到端的对话响应速度。
11. 结论
在系统内存充足的条件下,6 GB 显存可以支持 35B 级 MoE 模型达到实际可用状态。该结论的成立依赖三项前提:
其一,模型须为 MoE 架构。专家权重可从显存中分离是本结果得以成立的全部机制。
其二,系统内存容量须充足。本测试平台为 64 GB;在 16 GB 内存的设备上,结论不成立。
其三,上下文长度上限为 65536 tokens,且该条件下显存已无剩余容量。
在任务能力层面,5 项测试中 1 项通过、1 项部分通过、3 项未通过。其中 UI 组件生成一项值得注意:代码结构完整,实际渲染无有效输出。
后续工作
本研究仅完成官方 llama.cpp 基线测试。后续计划包括: TurboQuant KV Cache 量化分支的对照实验; 以及引入 4B / 8B 量级模型作为参照组, 以确定本地小模型与卸载运行的大模型在何种任务条件下各有优势。