KUN 技术志
6GB 显存笔记本,能把本地大模型跑到哪一步?
每期视频都配一篇可复核的文章:命令、参数、硬件和原始结果都在这里。
最新视频

6G 显存笔记本跑 24B:改 -ncmoe,三道真题全对
最受欢迎
评测
6GB 显存跑 35B MoE?真正撑场的是 64GB 内存
在系统内存充足的条件下,6 GB 显存可以支持 35B 级 MoE 模型达到实际可用状态。
评测
6G 显存笔记本跑 24B:改 -ncmoe,三道真题全对
在 RTX 3060 Laptop(6GB)+ 64GB 内存上,Liquid AI LFM2.5-24B-A2B(Q4_0)可以本地跑通。默认 -ncmoe 40 约 1.3GB 显存;改成 30 后端到端更快,三道真题仍全对——包括 35B 做错的那道算账题。代价是思考链关不掉。
评测
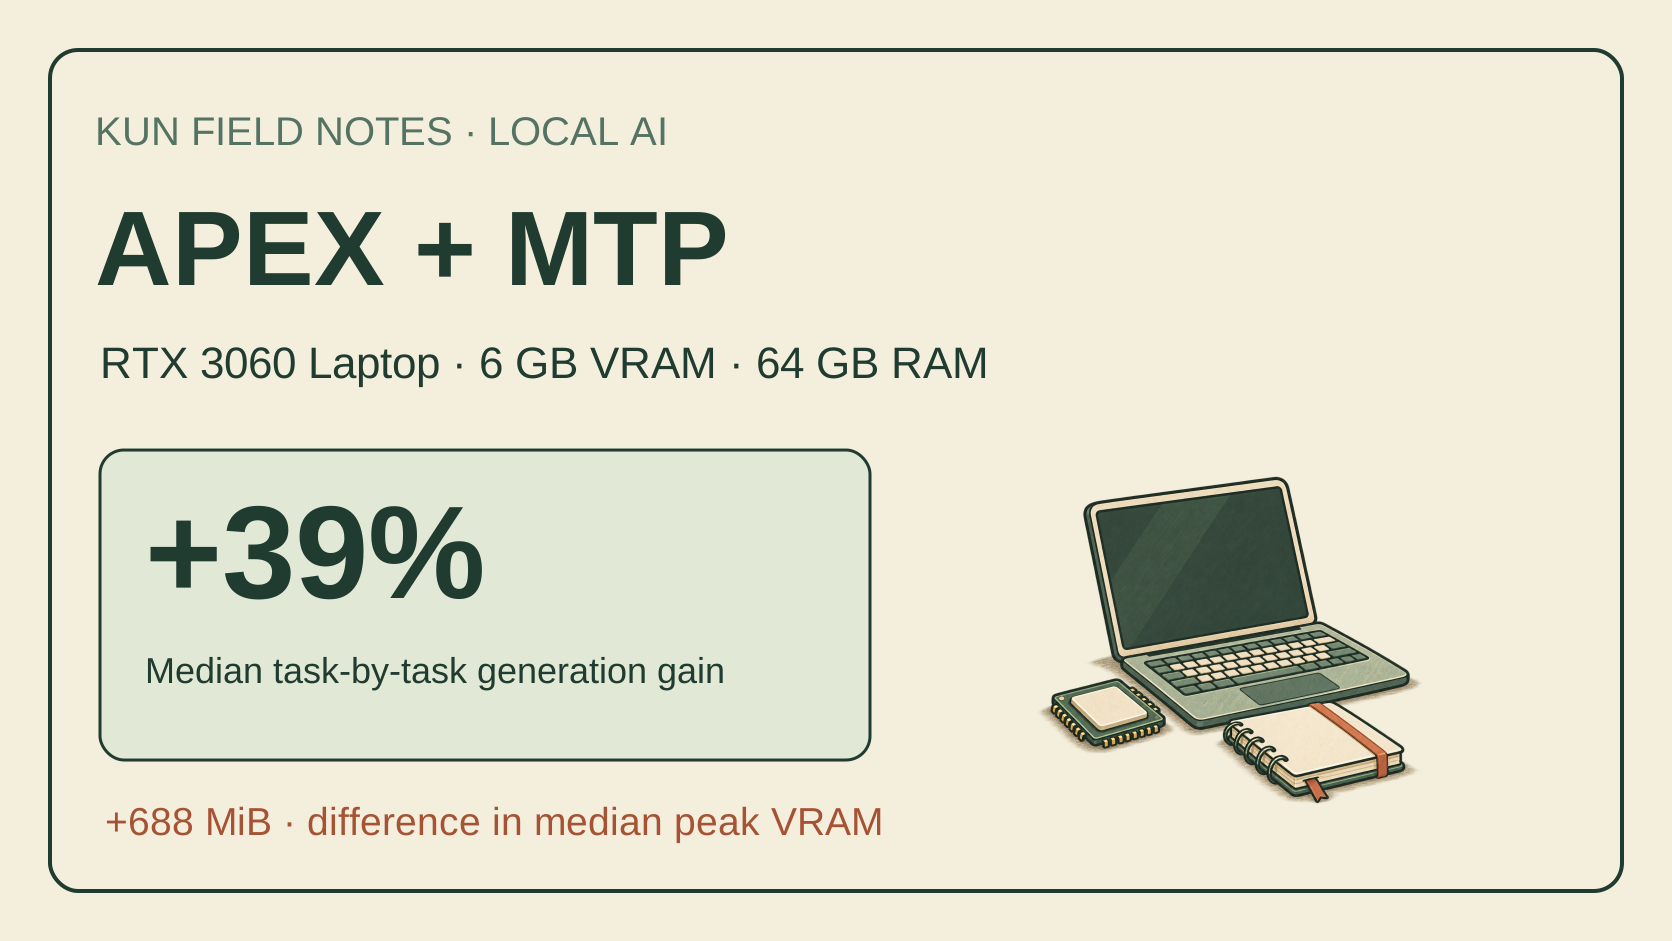
APEX+MTP 实测:6GB 笔记本生成提速中位 39%,代价是什么?
同一份权重,打开 MTP 后,12 道同题生成速度比值的中位数提高约 39%,显存峰值中位数增加约 688MiB。设备是 RTX 3060 Laptop 6GB、64GB 内存;答案变化和长文检索退步也保留在结果里。
最新文章
全部文章评测
6G显存笔记本跑125B:Strata每秒28–34个token,llama.cpp约12个,但Strata差点跑不起来
RTX 3060 笔记本 6GB 显存 + 64GB 内存,跑 125B 的 Qwen3.8 Flash Next(Q2_0)。Strata 聊天每秒 28–34 个 token,是 llama.cpp 的两倍多,4K 文档首字快一倍;但默认配置差 383MiB 显存起不来,关掉草稿层后只能开 8K 上下文。llama.cpp 慢,但 32K 照样跑。
项目记录
6GB 显存能跑哪些本地模型?实测清单(持续更新)
同一台 RTX 3060 Laptop 6GB + 64GB 内存,我们实测过的语言、图像和世界模型,每一行都链到完整测试。只收自己跑过的。
评测
编程智能体开口前要先读多少字?pi 1.4k、Codex 6.4k、Claude Code 15.8k tokens
从 llama-server 日志里读出三个智能体第一次请求的提示词长度和处理耗时。在 6GB 笔记本上,光读提示词,Claude Code 就比 pi 慢 8.6 倍。
喜欢这种“自己跑一遍”的实测?
新视频先发 B 站和 YouTube,文章同步更新。