文章
本地模型、AI Agent、开发工具、部署与排障实践。
6G显存笔记本跑125B:Strata每秒28–34个token,llama.cpp约12个,但Strata差点跑不起来
RTX 3060 笔记本 6GB 显存 + 64GB 内存,跑 125B 的 Qwen3.8 Flash Next(Q2_0)。Strata 聊天每秒 28–34 个 token,是 llama.cpp 的两倍多,4K 文档首字快一倍;但默认配置差 383MiB 显存起不来,关掉草稿层后只能开 8K 上下文。llama.cpp 慢,但 32K 照样跑。
6GB 显存能跑哪些本地模型?实测清单(持续更新)
同一台 RTX 3060 Laptop 6GB + 64GB 内存,我们实测过的语言、图像和世界模型,每一行都链到完整测试。只收自己跑过的。
编程智能体开口前要先读多少字?pi 1.4k、Codex 6.4k、Claude Code 15.8k tokens
从 llama-server 日志里读出三个智能体第一次请求的提示词长度和处理耗时。在 6GB 笔记本上,光读提示词,Claude Code 就比 pi 慢 8.6 倍。
同一个本地模型,pi 12/12、Claude Code 7/12:6GB 显卡实测三个编程智能体
LFM2.5-24B 和 Qwen3.6-35B 跑在 6GB 笔记本的 llama.cpp 上,分别接 pi、Codex、Claude Code 做三道题。pi 全过且最快;Codex 全过但工具参数错了 12 次;Claude Code 系统提示词吃掉半个上下文,还出现“说做完了、目录是空的”。
Claude Code 接 llama.cpp 本地模型:能跑,但 32K 上下文先被吃掉一半
llama-server 自带 Anthropic 兼容接口,Claude Code 改个地址就能连本地模型。我们在 6GB 笔记本上跑通了;但它的系统提示词约 1.6 万 token,小上下文模型上会出现“Prompt is too long”。
Codex CLI 接本地模型:配置写法,和那 12 次 “expected i32”
用自定义 model_provider 把 Codex CLI 指向 llama-server。LFM2.5-24B 上 12 项全过,但工具参数类型错了 12 次,它靠重试自救,第一次修 bug 跑了 599 秒。
本地大模型怎么测才可复现:KUN 的测试方法
先问“能不能用”而不是“能不能跑”;先建基线再加变量;粗扫后再加密。所有数字都能追到原始日志。这些规则来自一次次踩坑。
llama.cpp CUDA 编译教程:Windows 笔记本用 WSL2 跑通 RTX 3060
在 Windows 11 笔记本上,用 WSL2 + CUDA 12.8 编译 llama.cpp,生成 llama-server、llama-bench。我们所有 6GB 实测都用这套环境,三个参数最容易填错。
llama.cpp 跑 MoE,把专家层全扔给 CPU 反而快 4 倍:-ncmoe 调参实测
6GB 笔记本上,Qwen3.6-35B-A3B 的专家层全放 GPU 时生成 5.2 t/s,全放内存时 21.5 t/s,显存还少一半。但这不是定律:LFM2.5-24B 的最优点在中间。
一条命令把 llama-server 变成本地 OpenAI / Anthropic 接口(6GB 笔记本可用的参数)
llama-server 同时提供 OpenAI 兼容和 Anthropic 兼容接口,pi、Codex、Claude Code 都能直接连。这里给出我们在 6GB 笔记本上跑智能体时实际用的参数,以及每个参数的作用。
国内下载 Hugging Face 大模型太慢?并发 Range 分块下载实测
下 16.6 GB 的 Qwen-Image 2.1 权重,curl 和官方客户端都中途卡住。换成 16 并发、32 MiB 分块的 Range 下载,主模型分块阶段约 15.8 MiB/s,两个文件 36 分钟下完并通过官方 SHA256。
Qwen-Image 2.1 在 6GB 显卡上写中文:同一句话,换个写法,文字正确率从 1/6 到 6/6
INT8 权重加 CPU 卸载,RTX 3060 Laptop 6GB 上 17 次生成全部成功,1024×1024 一张约 3 分钟。目标文字完全相同时,只给文案的写法严格通过 1/6,写清楚行次和边界的写法 6/6。
6G 显存笔记本跑 24B:改 -ncmoe,三道真题全对
在 RTX 3060 Laptop(6GB)+ 64GB 内存上,Liquid AI LFM2.5-24B-A2B(Q4_0)可以本地跑通。默认 -ncmoe 40 约 1.3GB 显存;改成 30 后端到端更快,三道真题仍全对——包括 35B 做错的那道算账题。代价是思考链关不掉。
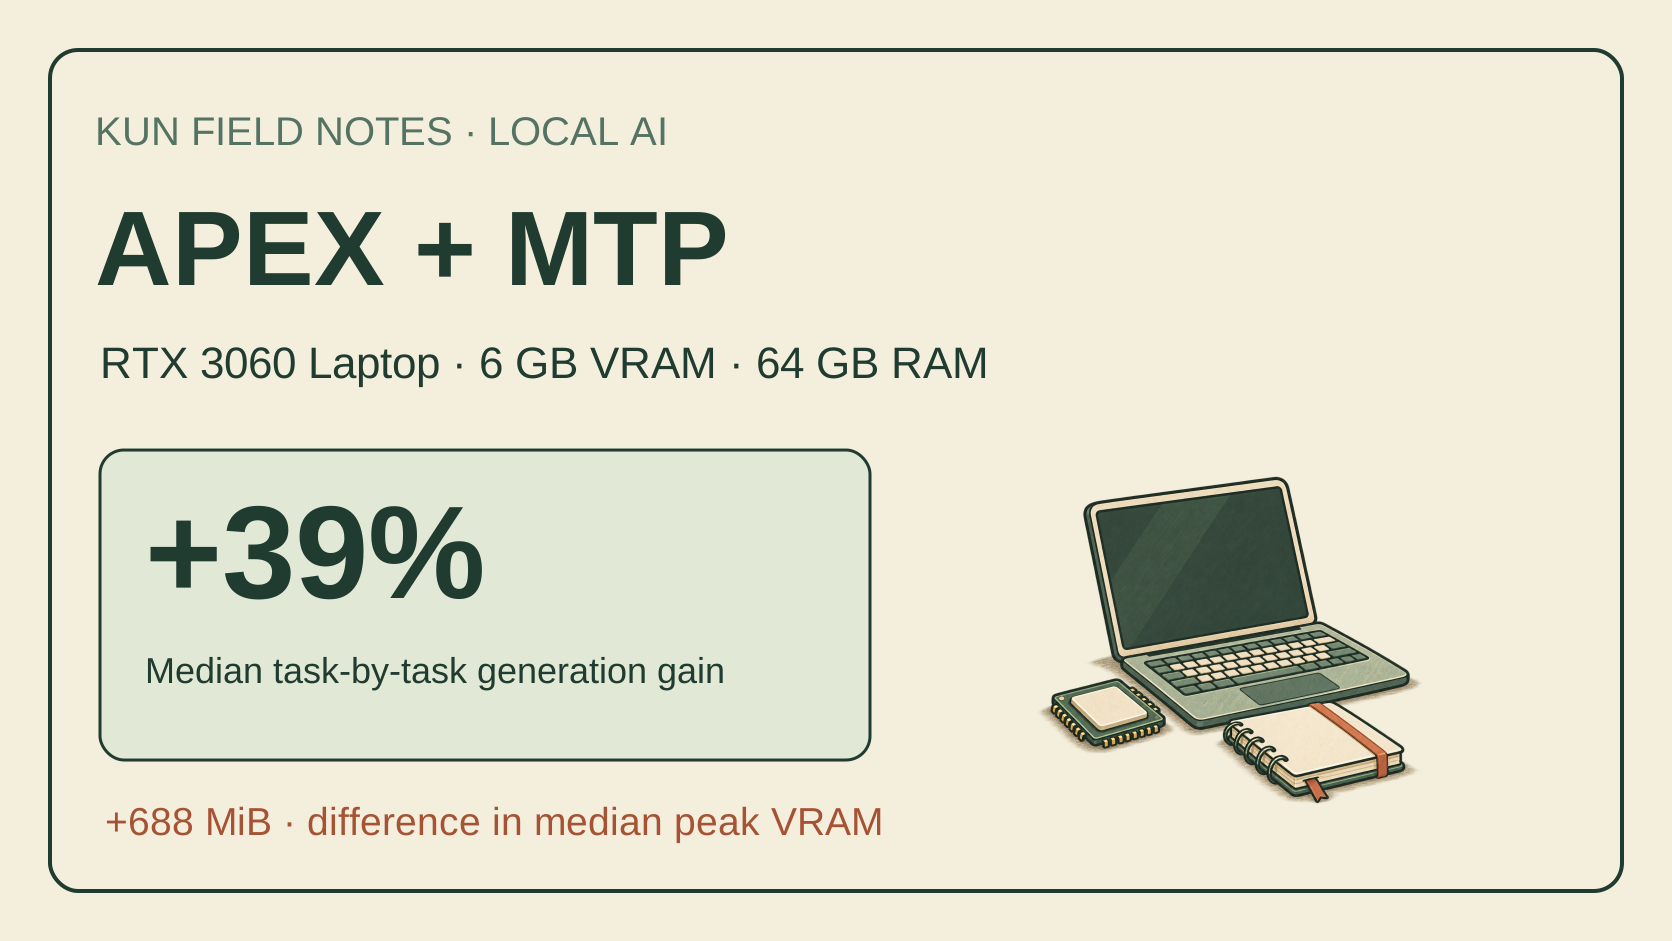
APEX+MTP 实测:6GB 笔记本生成提速中位 39%,代价是什么?
同一份权重,打开 MTP 后,12 道同题生成速度比值的中位数提高约 39%,显存峰值中位数增加约 688MiB。设备是 RTX 3060 Laptop 6GB、64GB 内存;答案变化和长文检索退步也保留在结果里。
Spark-X2.5-4B 实测:6GB 笔记本上,谁能更快把事做对?
同一台 6GB 显存的笔记本上,Spark-X2.5-4B 完整装进显存,Qwen3.6-35B-A3B 靠系统内存运行。72 个正式 run 之后,快和准落在了不同地方:主任务 Spark 快几十倍,24 道题却是 Qwen 通过得更多。
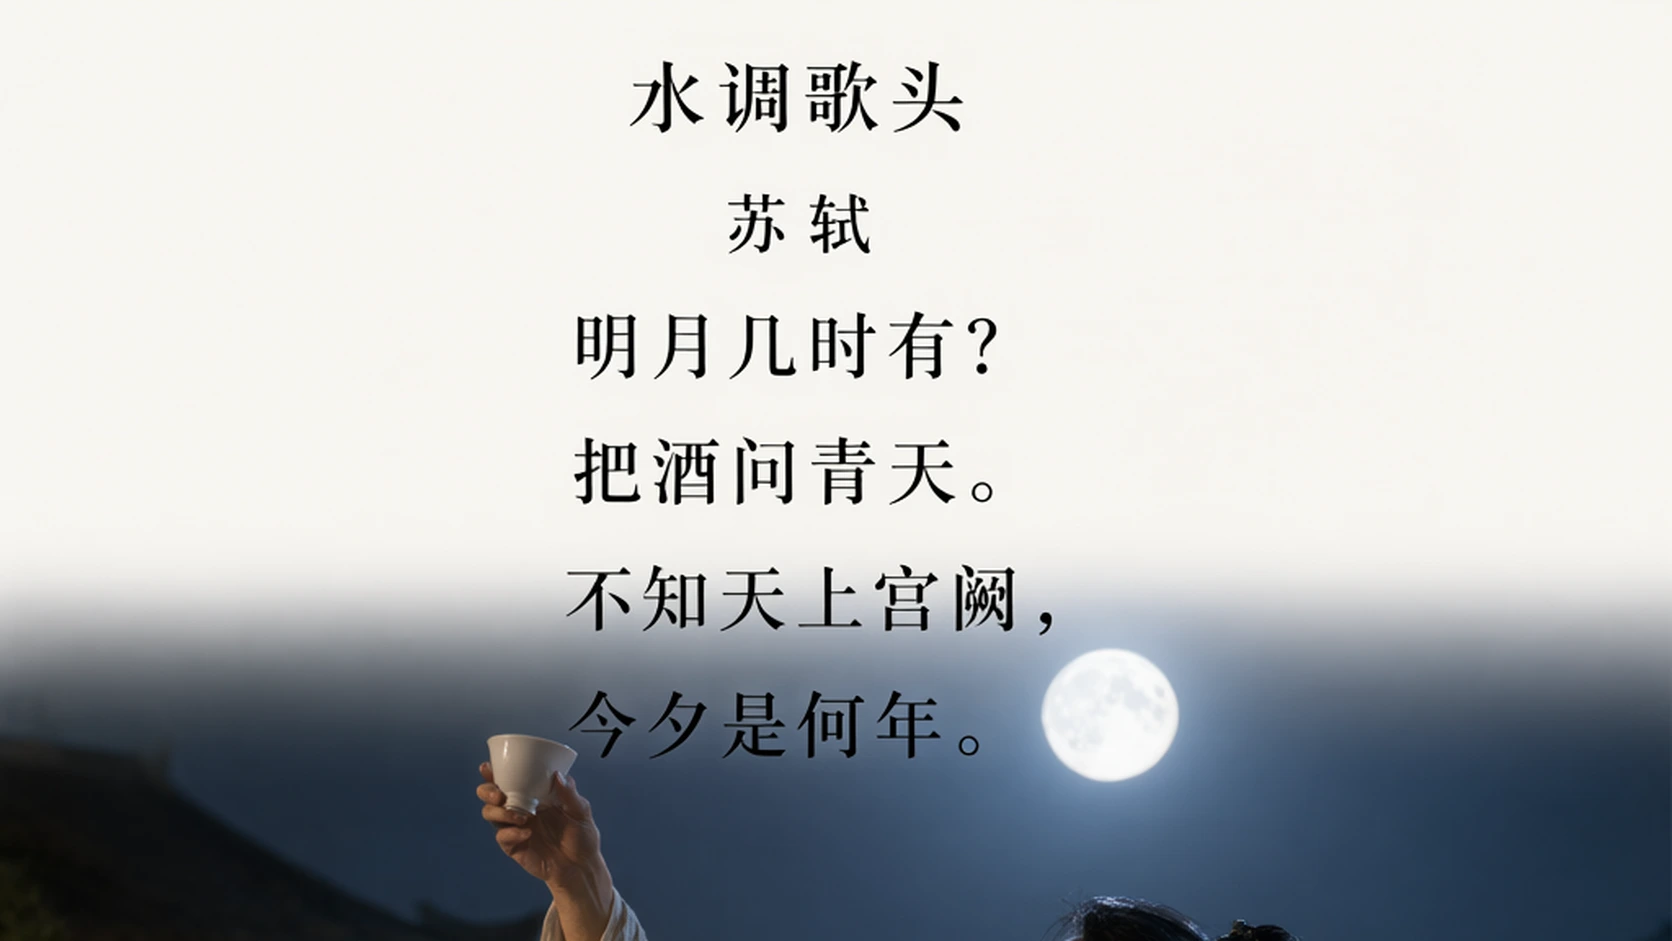
6GB 显卡生成诗词海报:单张约 4 分钟,16 张里 8 张文字未过
在 6 GB 显存的笔记本 GPU 上,Qwen-Image 2.1 能把诗句、场景和人物画进同一张图;限制它的是文字准确率,16 张里只有 8 张文字完全正确。
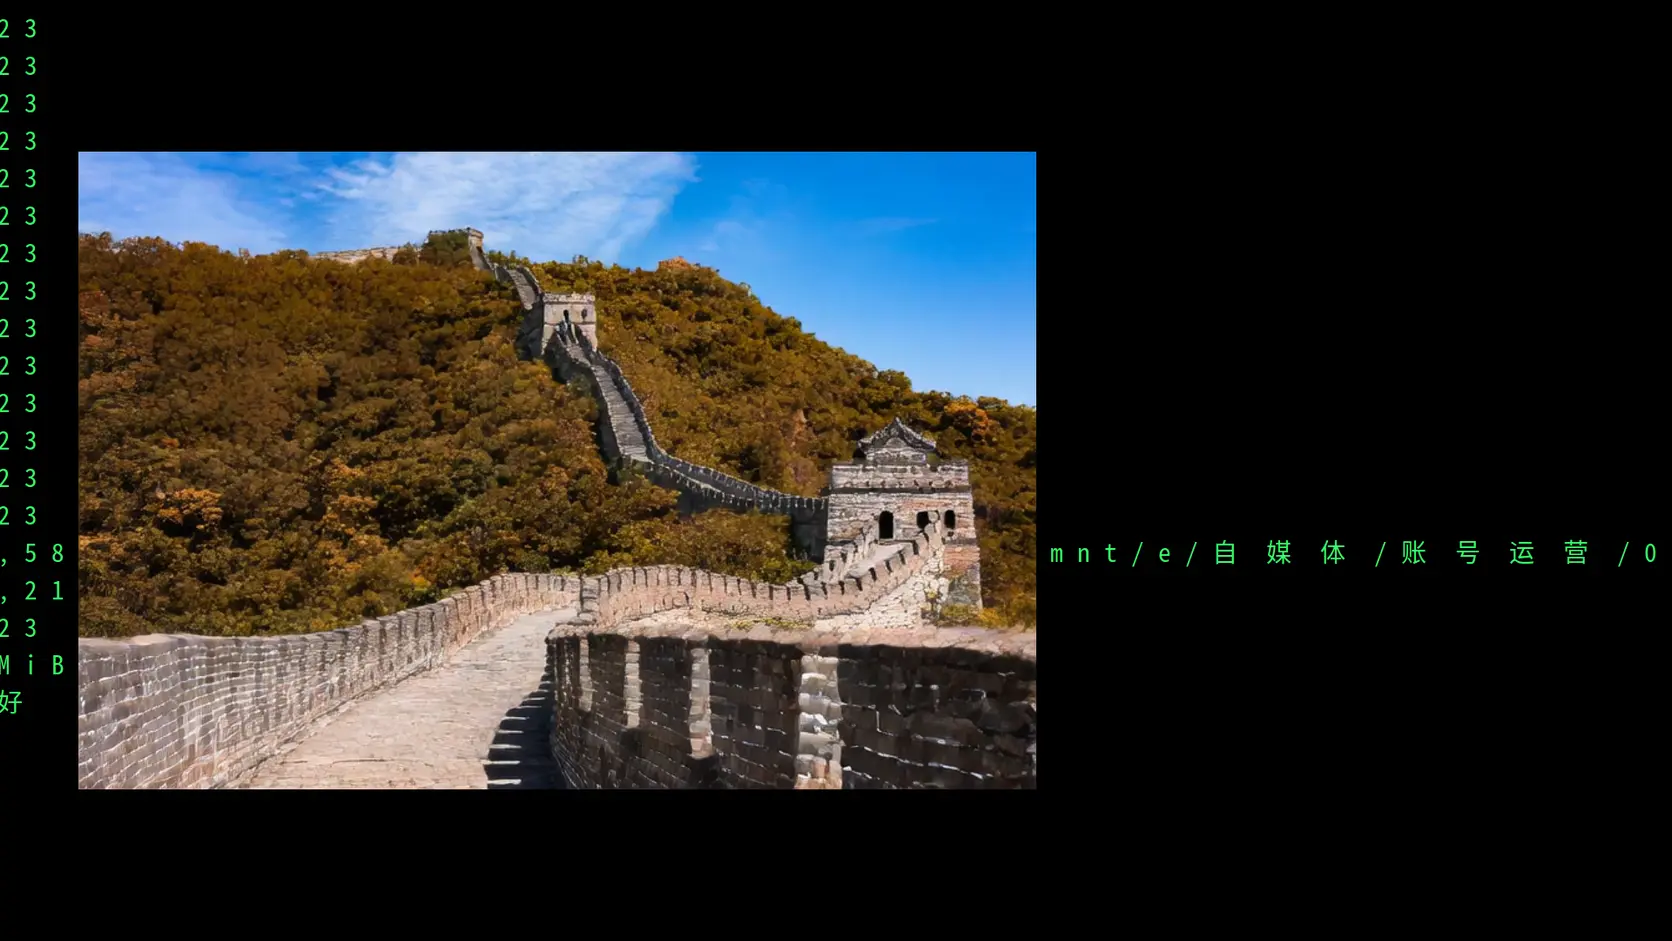
6GB 显存也能跑世界模型,而且能出片
在 6 GB 显存的笔记本 GPU 上,1.3B 的世界模型能跑出成片。代价是时间:不到 1 秒的画面要生成十多分钟,镜头也还不太听话。
6GB 显存跑 35B MoE?真正撑场的是 64GB 内存
在系统内存充足的条件下,6 GB 显存可以支持 35B 级 MoE 模型达到实际可用状态。
Windows 原生部署 LingBot-World 1.3B:6GB 显存笔记本跑通 13 帧图生视频
从零到出片:记录环境、克隆已打补丁的分支、aria2 多连接下载、CUDA 闸门、13 项权重校验,最后跑出 832×464 的 13 帧图生视频。命令可直接复制,每一步都给出判断标准;上游在 Windows 上会卡住的 flash-attn 问题放在文末说明。