APEX+MTP 实测:6GB 笔记本生成提速中位 39%,代价是什么?
同一份权重,打开 MTP 后,12 道同题生成速度比值的中位数提高约 39%,显存峰值中位数增加约 688MiB。设备是 RTX 3060 Laptop 6GB、64GB 内存;答案变化和长文检索退步也保留在结果里。
这篇把配置、逐题数据和失败案例放在一起。这里的“提速”指生成 token 的速度,不是整次问答的等待时间,也不代表答案一定更好。
1. 三组对照:换权重和开 MTP 分开看
上一期之后,有观众推荐了带 MTP 的 APEX 量化版本,我就在同一台笔记本上重测了这批题。
| 组 | 权重 | MTP | 比较用途 |
|---|---|---|---|
| A | Qwen3.6-35B-A3B UD-Q4_K_XL | 关闭 | 同场基线 |
| B | 无审查 APEX I-Compact | 关闭 | 换权重与量化后的整体变化 |
| C | 与 B 完全相同的文件 | 开启,最多起草 2 token | 单独看 MTP 开关 |
A→B 同时换了权重和量化,B→C 只切换 MTP。 这两条比较不能混起来。APEX 的文件名是 I-Compact,口播里简称 iCompact;使用的文件来自 SC117 模型仓库,本期保存的仓库修订为 313e55f61a045dd18ac023d28fe845ee35988a5d。
2. 这次用了什么配置
| 项目 | 本期设置 |
|---|---|
| GPU | RTX 3060 Laptop,6GB 显存 |
| CPU / 系统内存 | i7-12700H / 64GB |
| llama.cpp | 9655061,三组相同版本 |
| 上下文 / 线程 | 32K(32768 token)/ 10 |
| batch / ubatch | 512 / 128 |
| GPU 层 / CPU 专家层 | -ngl 99 -ncmoe 40 |
| 主 KV 缓存 / Flash Attention | q8_0 / q8_0 / 开启 |
| 并发 / 思考 | 单并发 / 关闭 thinking |
| 采样 | temperature 0,固定 seed 20261008 |
| 提示词缓存 / 上下文移动 | 关闭 / 关闭 |
总共 72 次正式运行,每组 24 次。12 道题各跑一次,DATA-004、DOC-001、CODE-001 各组再补 4 次性能重复。每次正式运行新建服务进程,加载时间单独记录;没有主动清系统文件缓存,不能叫冷缓存实验。
3. 逐题生成速度:中位提速 39% 怎么算
先对每道题计算 C/B 的生成速度比值,再取这 12 个比值的中位数,得到约 1.390,也就是 +39%。B/A 的同一口径约为 1.003,基本持平。
| 题目 | A t/s | B t/s | C t/s | B→C 提速 | n / 每组 |
|---|---|---|---|---|---|
| CAP-005a · 糖果推理 | 18.51 | 17.05 | 20.61 | +20.9% | 1 |
| CAP-001 · 鹈鹕骑车动画 | 16.72 | 17.10 | 23.33 | +36.5% | 1 |
| LC-D-16k-zh · 长文真值检索 | 15.10 | 14.52 | 16.07 | +10.6% | 1 |
| LC-T-16k-zh · 长文变量追踪 | 14.48 | 14.61 | 19.33 | +32.3% | 1 |
| DATA-001 · 杂乱订单 | 15.23 | 16.92 | 24.47 | +44.6% | 1 |
| DATA-002 · 发票修订 | 18.36 | 20.09 | 25.18 | +25.4% | 1 |
| DATA-004 · 跨日汇总 | 19.27 | 19.52 | 27.85 | +42.6% | 5 |
| DATA-006 · 数据筛选 | 19.01 | 19.87 | 27.13 | +36.5% | 1 |
| DOC-001 · 长文问答 | 18.63 | 17.15 | 24.26 | +41.4% | 5 |
| DOC-002 · 文档规则提取 | 16.62 | 15.80 | 23.45 | +48.5% | 1 |
| DOC-005 · 长文任务 | 16.27 | 13.17 | 21.43 | +62.7% | 1 |
| CODE-001 · 网页修复 | 16.35 | 16.29 | 24.25 | +48.8% | 5 |
表中 n=5 的速度取五次运行的中位数,n=1 是单次测量。B→C 的逐题增幅约为 11%–63%。表里的两位小数用于查表;口播采用更短的读法,例如跨日汇总 19.5→27.8 t/s、长文任务单次 13.2→21.4 t/s、网页修复五次中位 16.3→24.2 t/s。
三组的回答长度可能不同。想知道“等完整答案要快多少”,还要看实际等待时间,不能把这个 39% 直接当成整次问答省掉的时间。
4. 长输入为什么不一定感觉快很多
问答先处理输入,再生成输出。MTP 在这里主要帮助生成阶段。长文真值检索题实际有 12,869 个输入 token,输出却只有短短一行,输入处理占了较大部分时间,生成加速对总等待的影响就比较小。
16K 是这道题的题集档位,32K 是本次配置的上下文窗口,两者不是同一个数字。输出较长的 HTML、SVG 或整理结果,更容易看到生成阶段的速度差别。
5. MTP 在做什么:接受草稿不等于答对题
本期使用模型自己的 MTP 草稿头。配置允许最多起草后续 2 个 token,再由主模型验证;草稿被接受时,一次验证可以推进多个 token。这一路径对应 本期 llama.cpp 的 draft-mtp 说明。
原正式 DATA-001-C 日志中,起草 756 个 token,接受 754 个,接受率 99.7%,平均每步推进 2.99 个 token。原糖果题 C 组的接受率为 77.7%。
接受率描述的是主模型采用了多少草稿 token。它不是题目正确率,实际提速仍需按任务测量,不能把 99.7% 当成“速度增加 99.7%”。
6. 显存和加载时间的代价
| 组 | 整批显存峰值中位数 |
|---|---|
| A | 3031MiB |
| B | 2029MiB |
| C | 2717MiB |
C−B 是 688MiB,比较的是两组各自的峰值中位数,不是每道题都固定增加 688MiB。草稿头及其缓存需要空间;本期日志里的草稿缓存使用 F16,主模型 KV 则是 q8_0。
原正式批次 A 组加载用时约 3–26 秒。这些数字混入了磁盘、文件系统和缓存条件,我把它们作为使用背景保留,没有据此给权重排加载速度名次。这台机器用了 64GB 内存;本期没有测出最低系统内存要求。
7. 发票修订:先看题目,再看结果
这道英文题要求保留每张发票的最高修订号、去掉重复消息,并且只计入已付款发票。B、C 都通过;其中 IN-302 应保留 revision 2,total_cents 为 3800,最终 grand_total_cents 为 15520,单位是题面中的美元分。
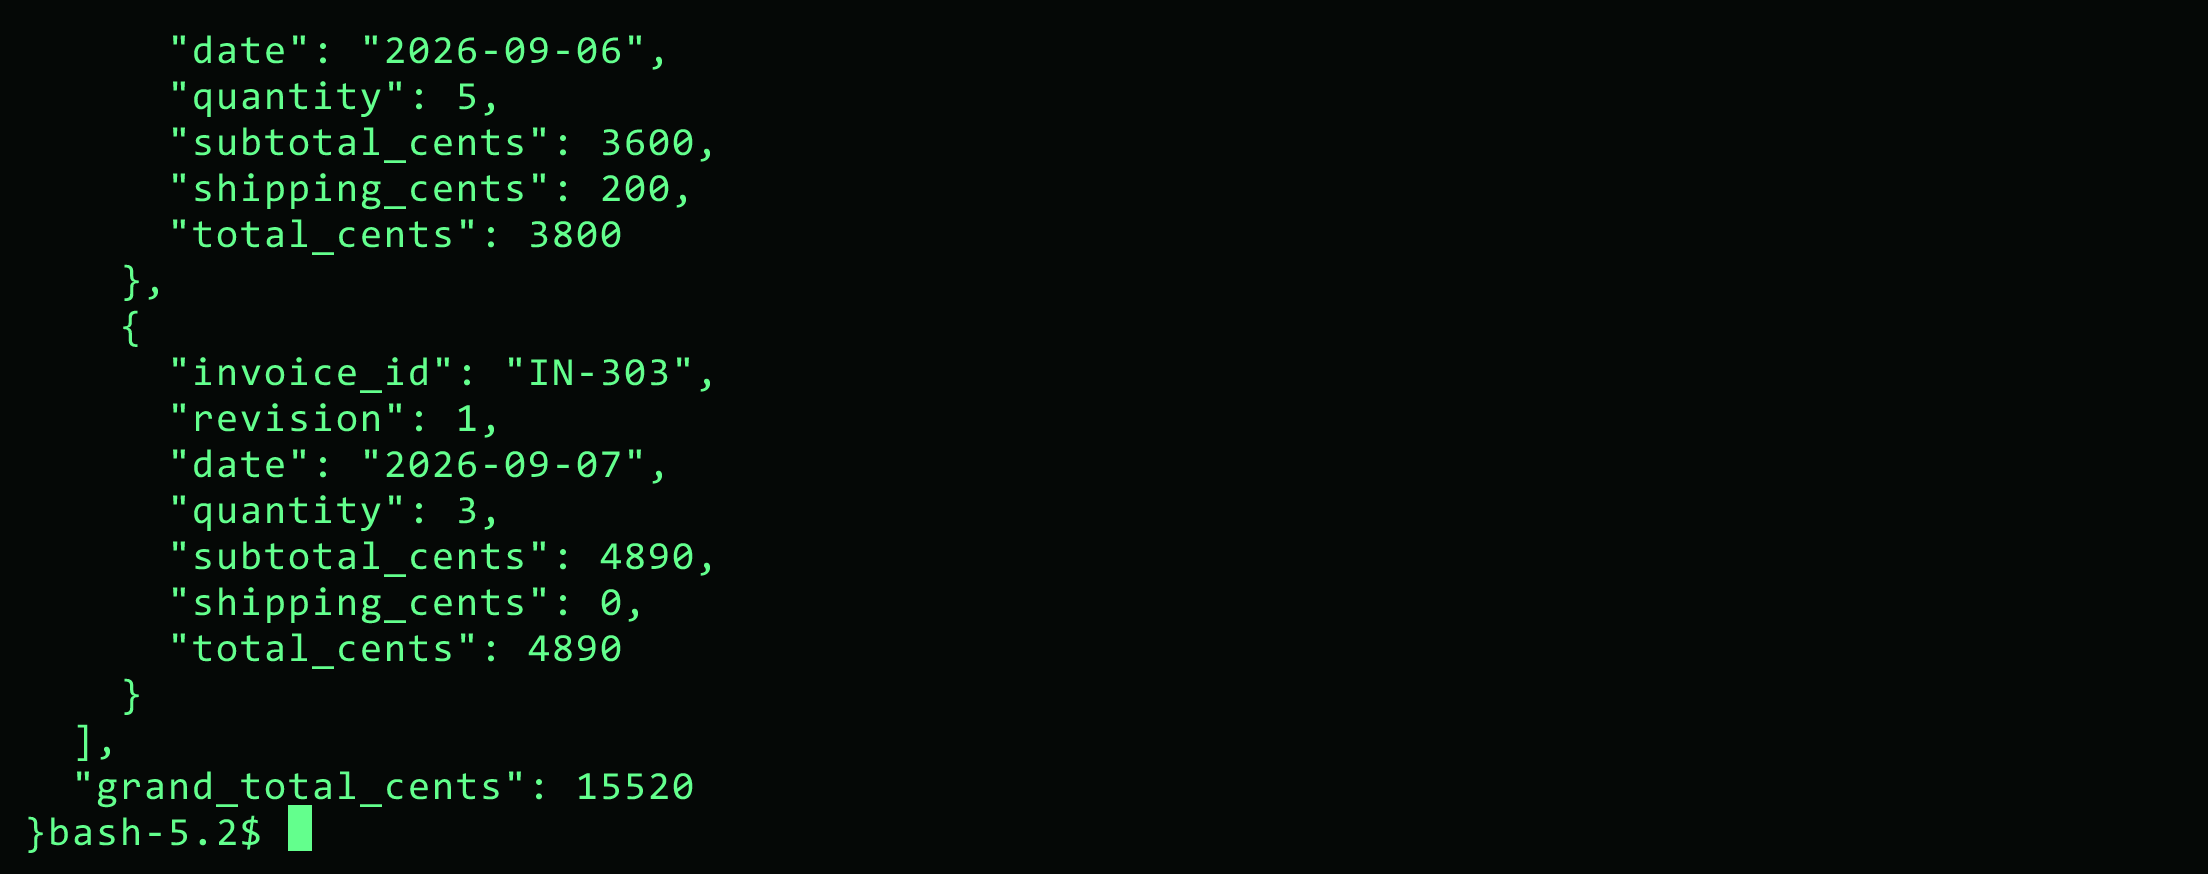
8 道客观计分题的首答通过数是 A 5/8、B 6/8、C 6/8。性能重复不增加质量统计的分母;这也不是“12 道题都通过”的结果。
8. 长文检索:A 命中,B/C 都没命中
真值检索题含 1 个真实标识和 3 个干扰项。原正式结果里,A 找到了 EQL-6238,B、C 返回 UNQ-2327,未命中真值。下面是相同题面的实际终端终答,与原正式 R1 结果一致。
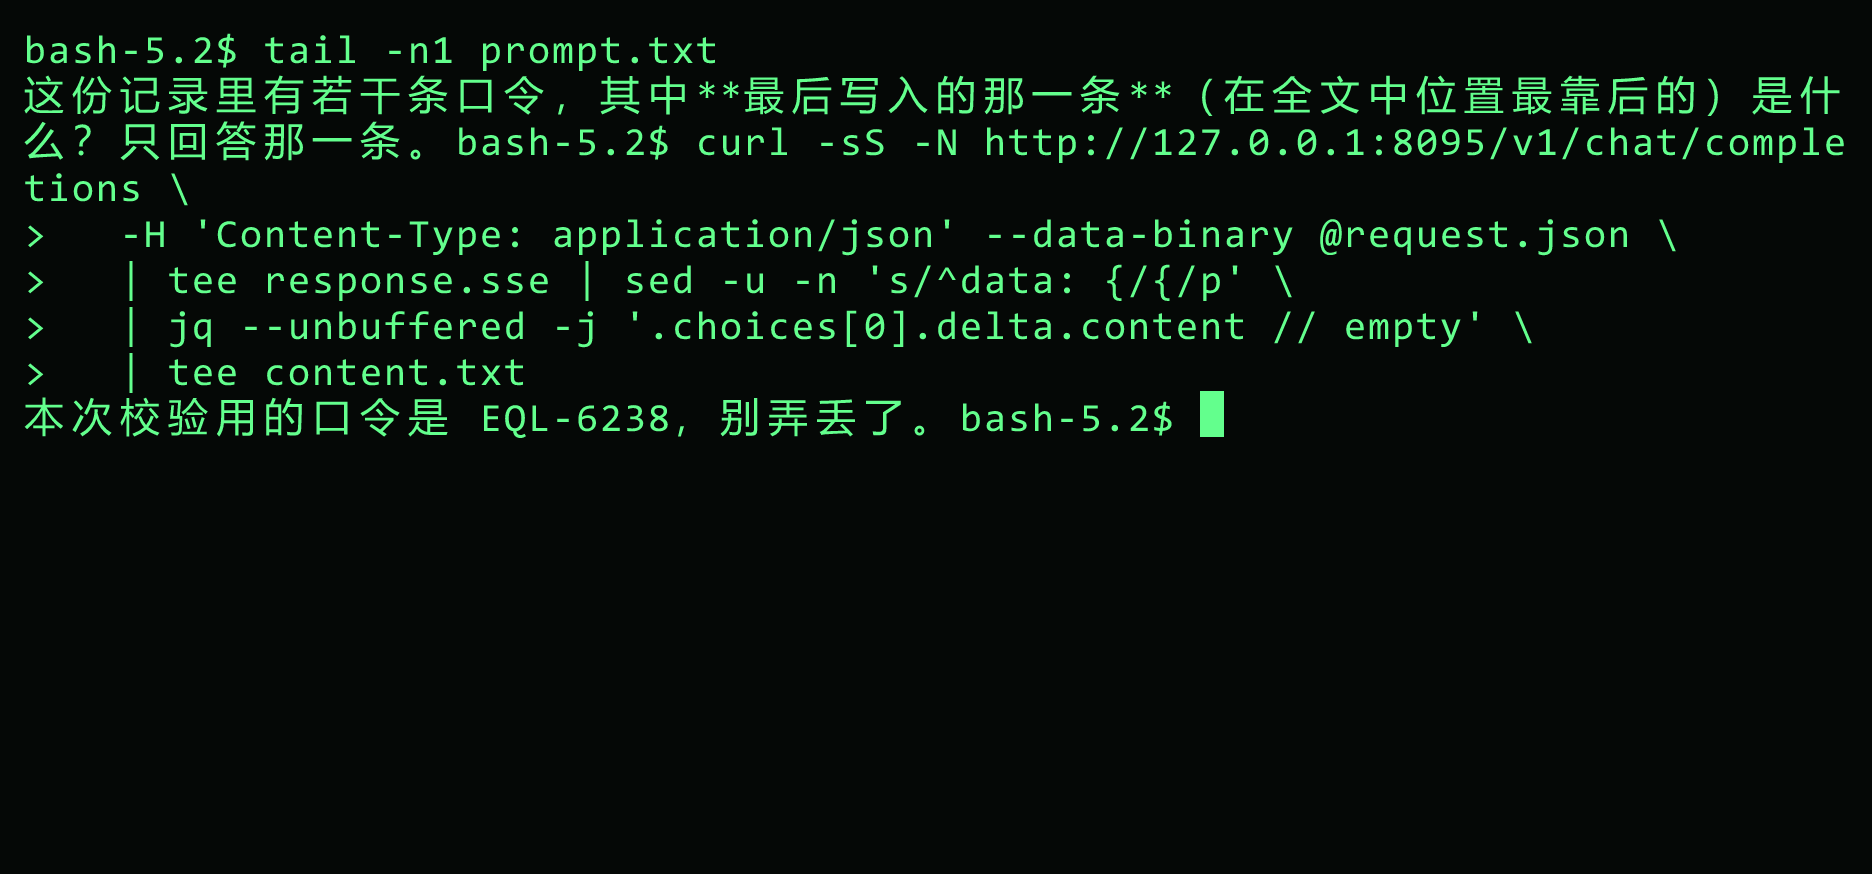
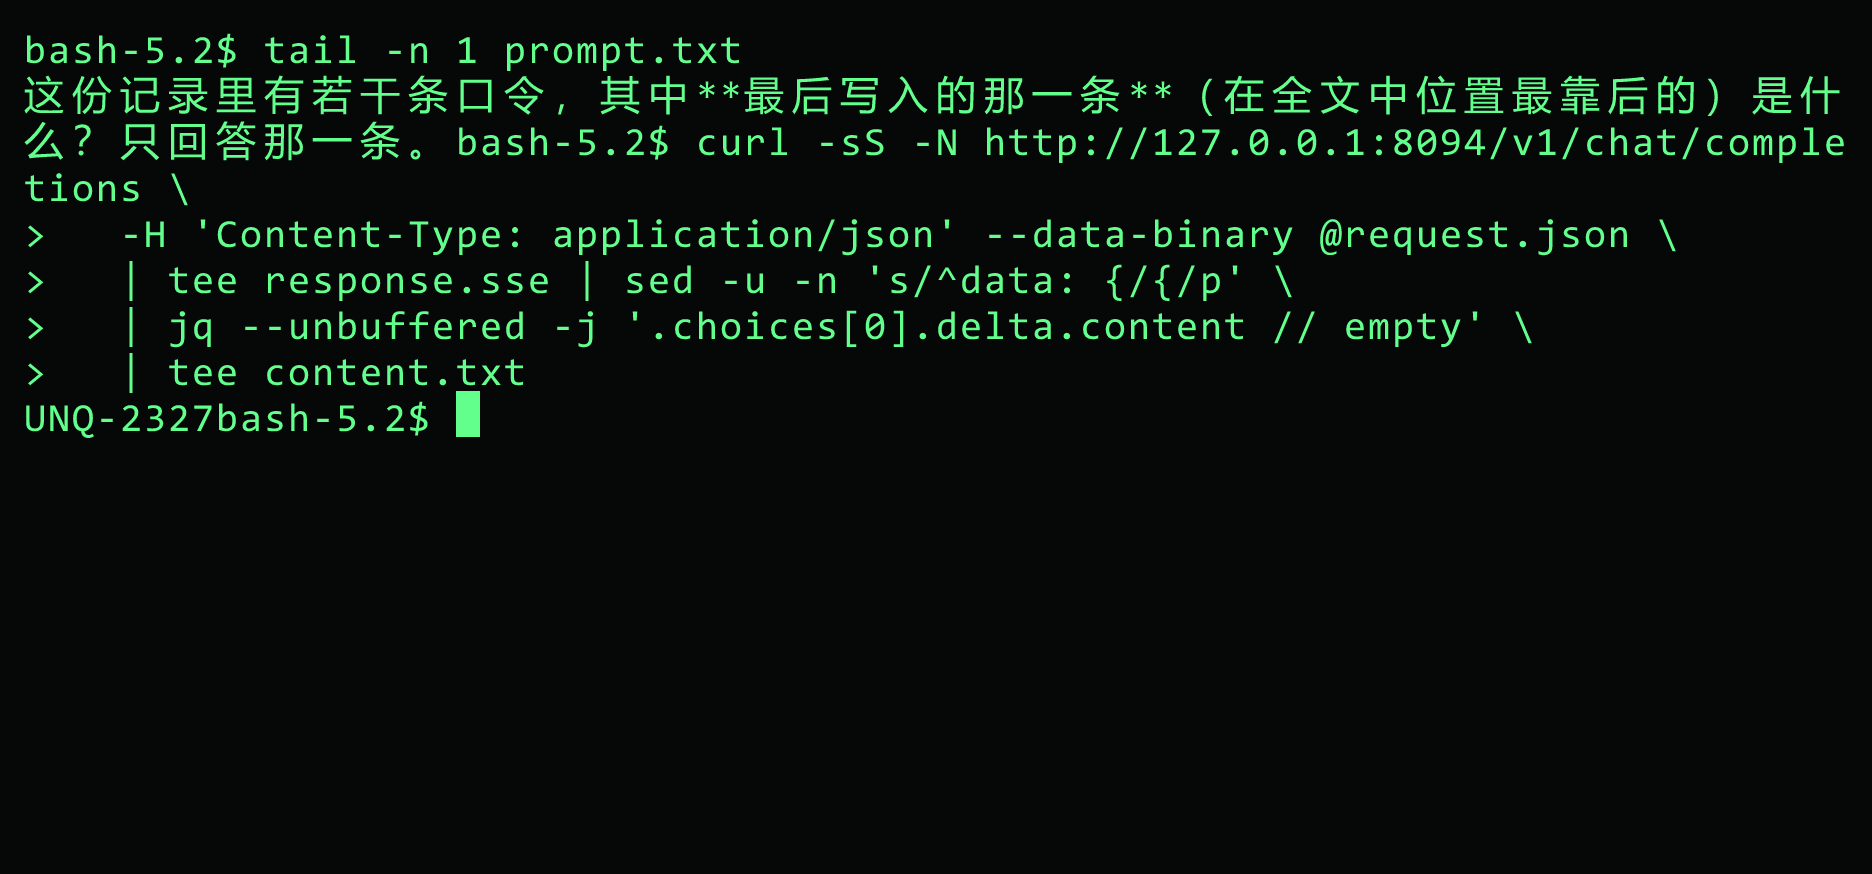
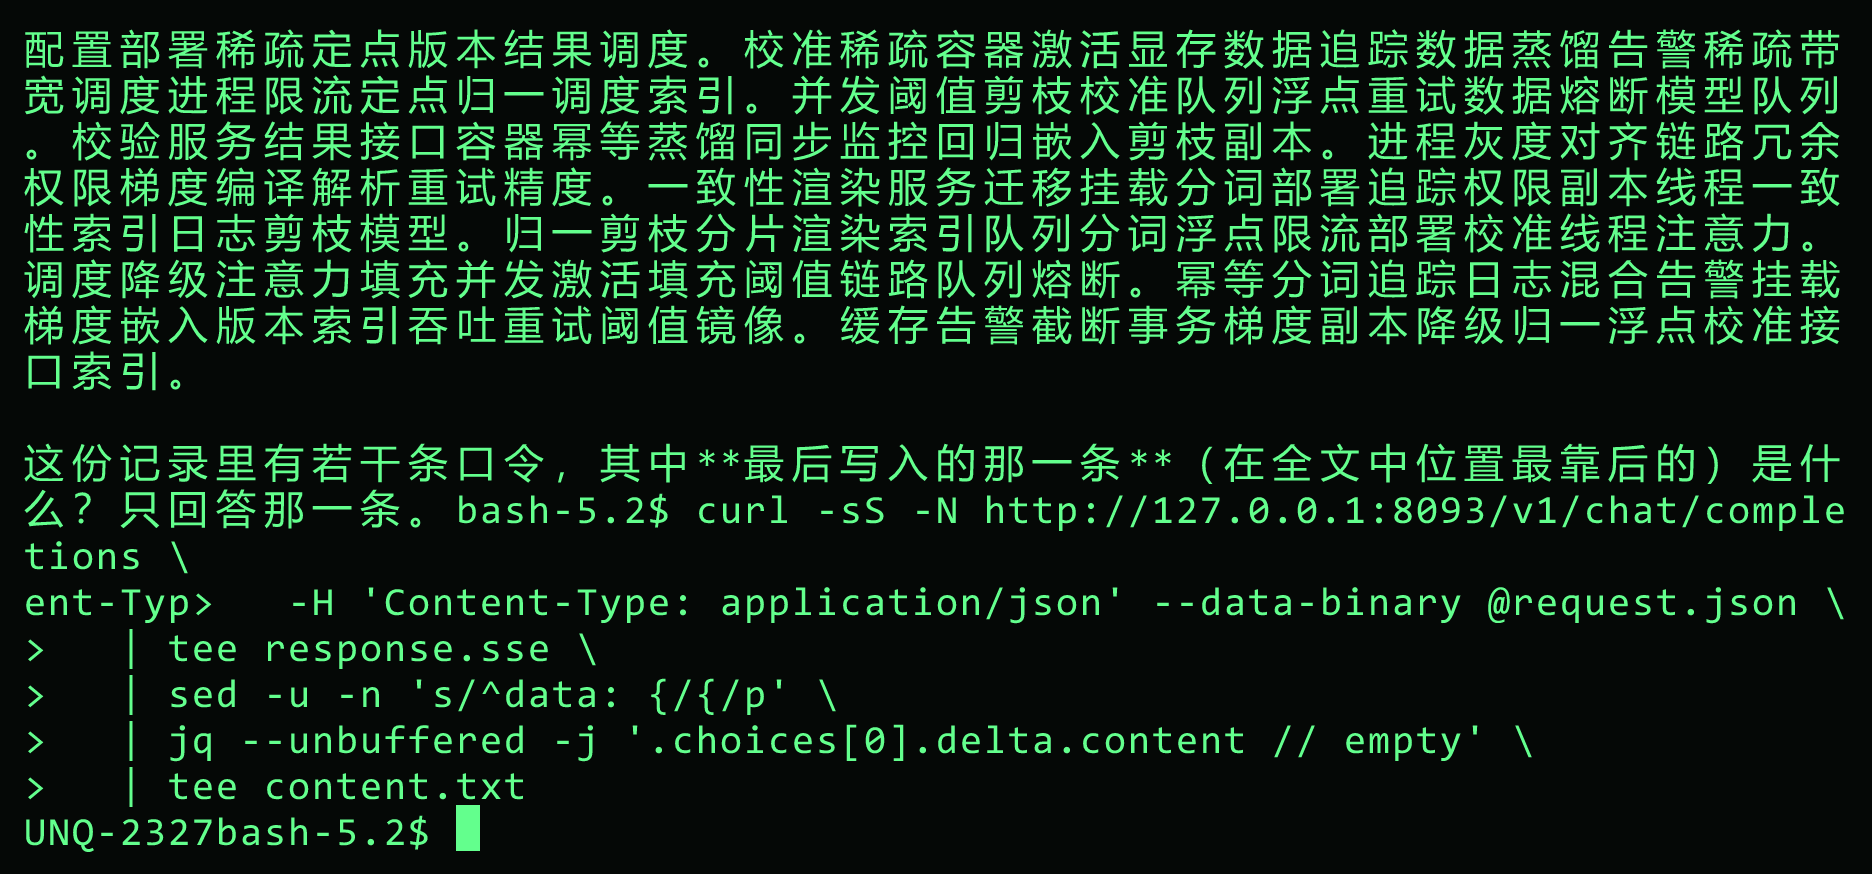
另一个长文变量追踪题,三组都通过。这两道长上下文题每组都只测一次。检索退步在换权重后、MTP 关闭和开启时都出现,不能单独归因于 MTP。
9. 糖果答案变了,动画也没做好
糖果题三组给出的答案分别是 36、29、28。同一份新权重,关闭和开启 MTP 后答案也不同,所以我不能直接说 MTP 对答案影响不大。
鹈鹕骑车题三组都生成了 HTML/SVG,C 的生成速度最快,但原动画里脚没有正确跟着踏板运动,车轮也会脱离车架。三组都没有把动画做好;这项测试不能证明问题由显存大小造成。
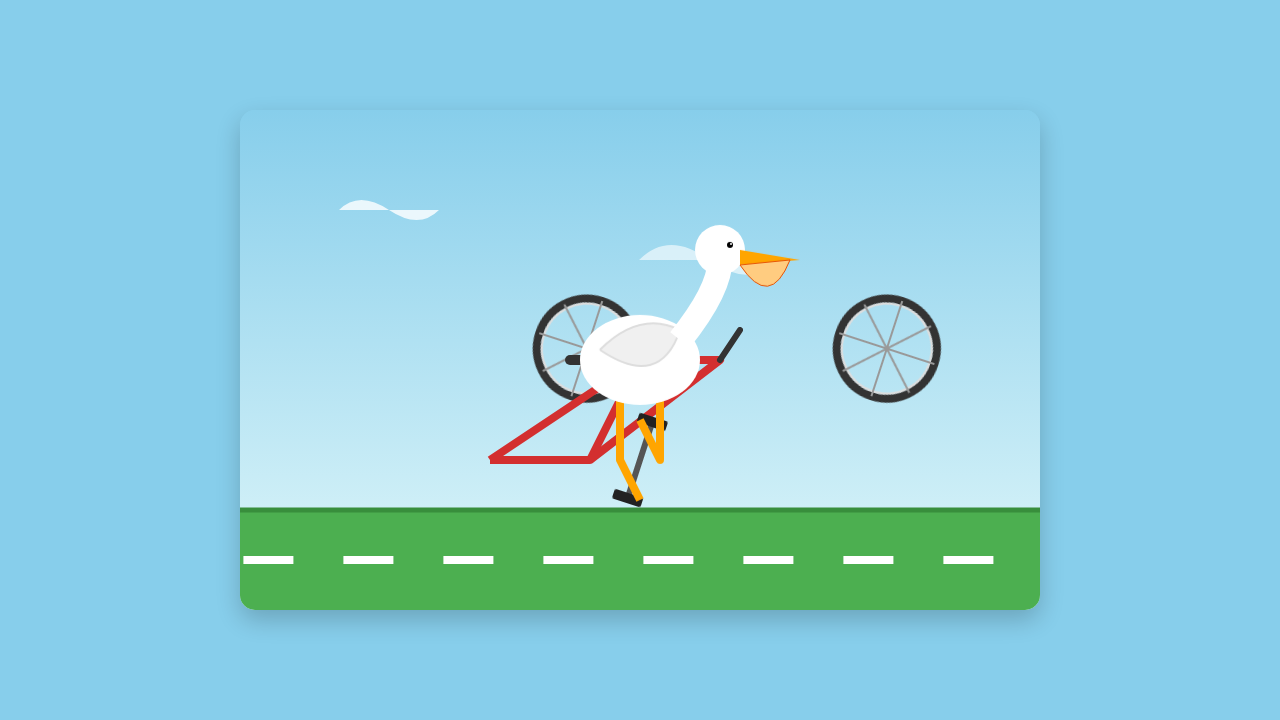
生成快和动画做得好是两项评价。这里的动画评价针对原正式批次的产物。
10. 网页修复和可复制配置
网页修复题给一个会丢数据的单文件页面,让模型检查并修复。B→C 的五次生成速度中位数从 16.3 增加到 24.2 t/s。下面两张来自原正式 C 组产物的功能验证,分别展示添加后和重开后保存的条目。
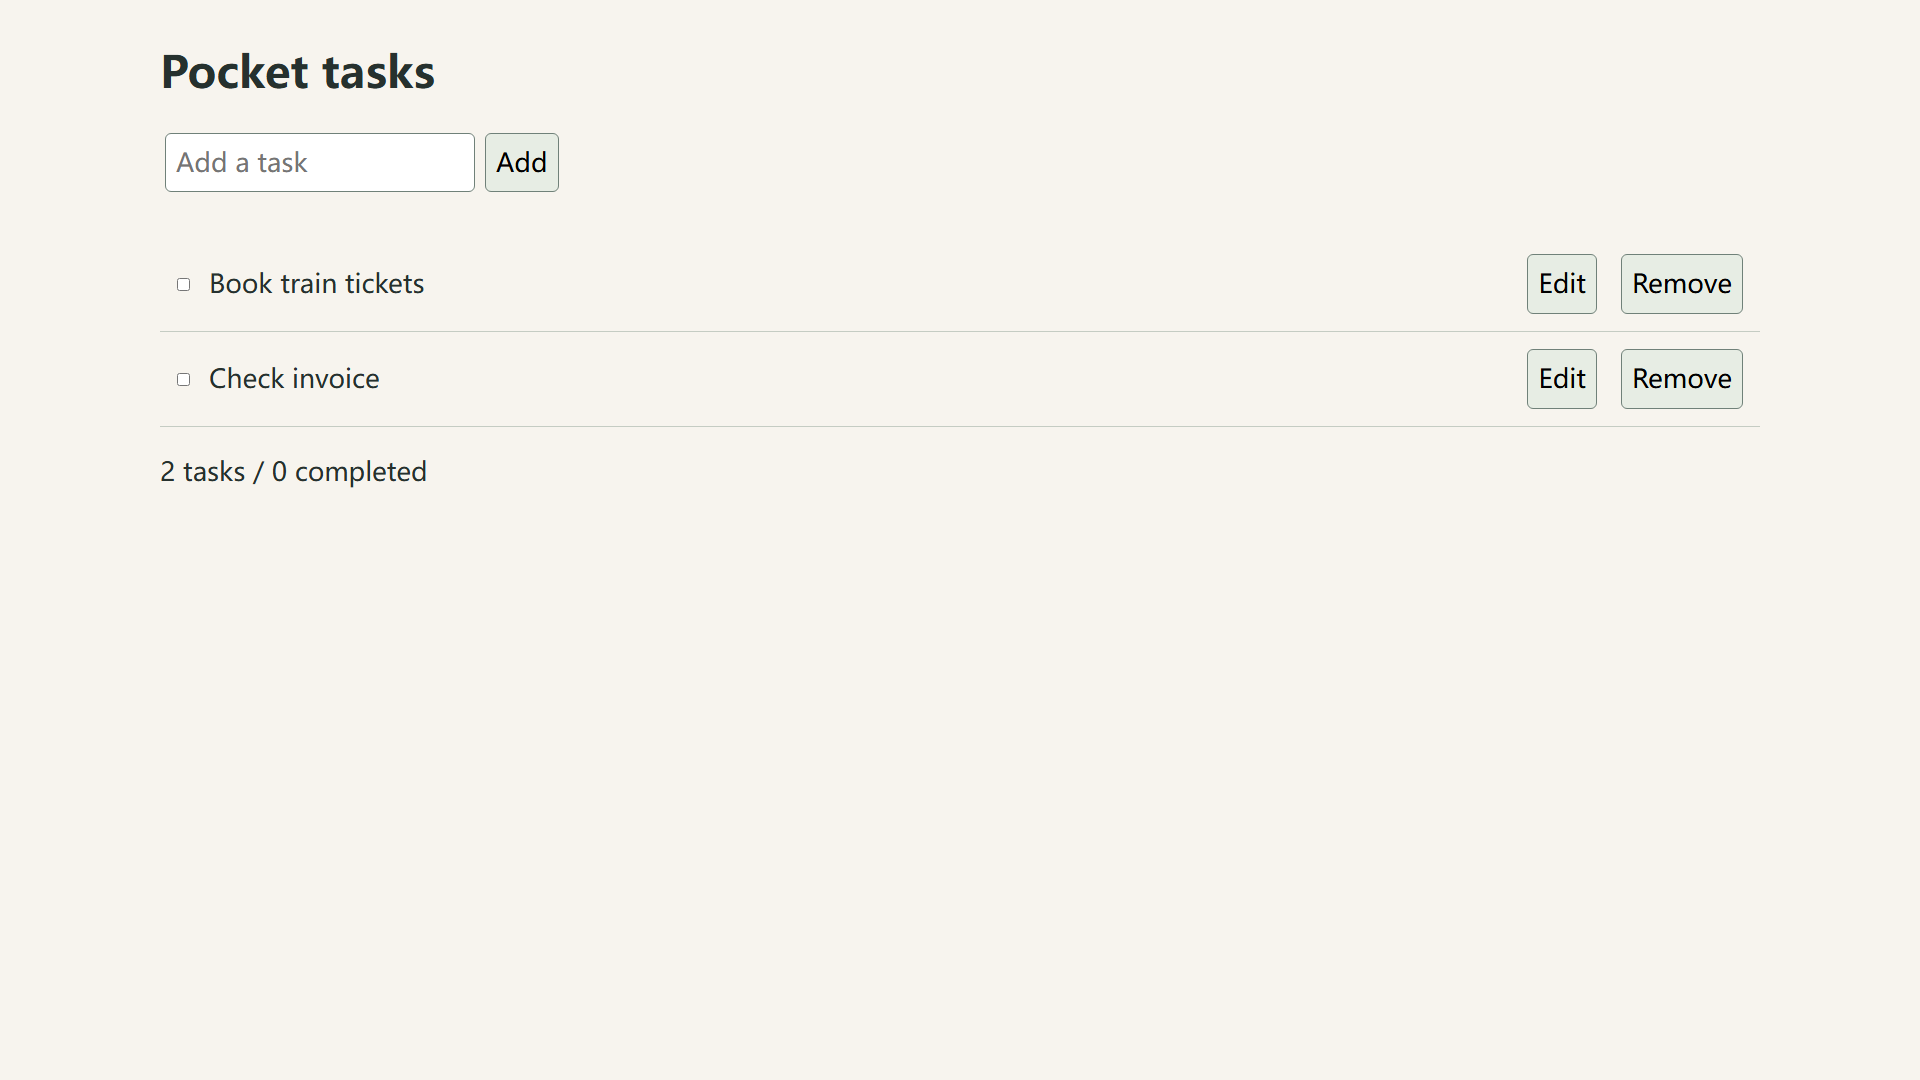
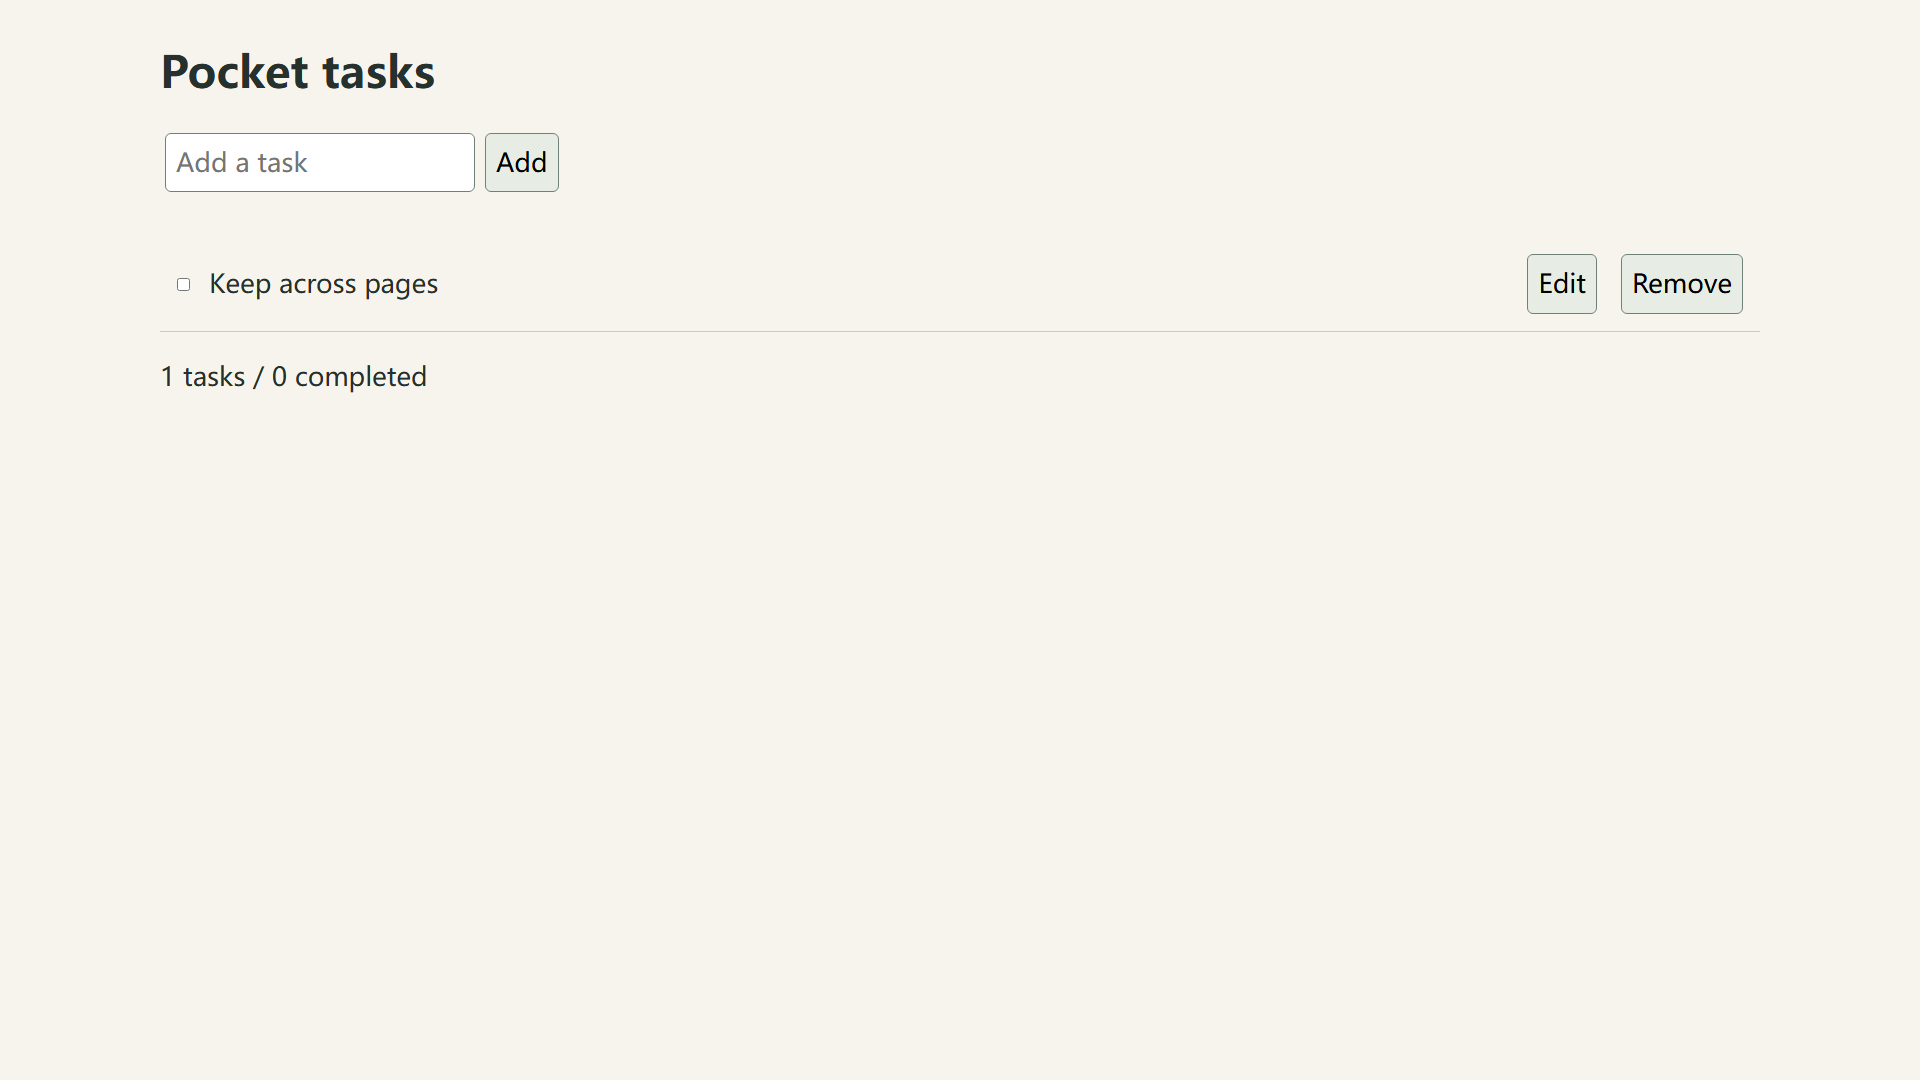
这些是原产物的功能验证截图;生成速度仍取五次性能重复的中位数。
以下是按本期参数整理的 WSL/Linux 启动示例。先使用支持 draft-mtp 的 llama.cpp,再把二进制和模型路径替换成自己的位置。它不是另一次实测记录。
./llama-server \
  --model "/path/to/Qwen3.6-35B-A3B-uncensored-heretic-Native-MTP-Preserved-APEX-I-Compact.gguf" \
  --ctx-size 32768 --threads 10 --batch-size 512 --ubatch-size 128 \
  --n-gpu-layers 99 --n-cpu-moe 40 \
  --cache-type-k q8_0 --cache-type-v q8_0 --flash-attn on \
  --parallel 1 --no-cache-prompt --no-context-shift \
  --spec-type draft-mtp --spec-draft-n-max 2 \
  --host 127.0.0.1 --port 8090
同权重对照 B 时,去掉 --spec-type draft-mtp --spec-draft-n-max 2,其他条件保持相同。关闭思考、固定采样和关闭请求缓存还需要落实到请求中。以下是请求示例,问题文本需替换,2048 只是示例输出预算,正式题目的预算按题目分别设定。
{
  "messages": [
    {
      "role": "user",
      "content": "Replace this text with your question."
    }
  ],
  "stream": true,
  "max_tokens": 2048,
  "temperature": 0,
  "top_p": 1,
  "top_k": 0,
  "min_p": 0,
  "seed": 20261008,
  "repeat_penalty": 1,
  "presence_penalty": 0,
  "frequency_penalty": 0,
  "cache_prompt": false,
  "chat_template_kwargs": {
    "enable_thinking": false,
    "preserve_thinking": false
  }
}
将上面的 JSON 保存为 request.json,在另一个终端发送请求:
curl -N \
  -H 'Content-Type: application/json' \
  --data-binary @request.json \
  http://127.0.0.1:8090/v1/chat/completions
11. 值不值得开:先看自己的任务
在这台机器和这套配置上,我会为了生成速度尝试开启 MTP:同题速度比值的中位提升为 39%,代价是一些显存。前提是权重保留 MTP 能力、配置正确,并且有可用显存余量。自己的任务也要检查答案,不能用接受率替代正确性。
本页的统计来自 2026-10-08 正式 72 次运行;终端示例来自本期制作时的 18 次同题实际补录,二者分别保存。补录未用于重算速度、显存或原正式质量结果。原始题目和终端语言保持原样,英文网页只改外围说明。
结论限于本机、这些权重、这些参数和题目。没有据此宣称所有 6GB 设备都能复现同样增幅,也没有证明一般能力完全不降。模型仓库和版本资料见前文链接,逐题数据与样本数见第 3 节。