Spark-X2.5-4B 实测:6GB 笔记本上,谁能更快把事做对?
同一台 6GB 显存的笔记本上,Spark-X2.5-4B 完整装进显存,Qwen3.6-35B-A3B 靠系统内存运行。72 个正式 run 之后,快和准落在了不同地方:主任务 Spark 快几十倍,24 道题却是 Qwen 通过得更多。
1. 结论:这次「快」和「准」不是同一件事
同一台笔记本上跑两个本地模型:Spark-X2.5-4B 完整装进 6 GB 显存, Qwen3.6-35B-A3B 是 MoE,40 层专家计算交给 CPU,权重主要靠 64 GB 系统内存。 24 道任务、72 个正式 run 跑完之后,两边的长处不在同一个地方。
三项预定主任务里,两边都做对了两项:读说明书回答三个问题、修好一个刷新就丢内容的待办清单。这两项里 Spark 快得多——说明书题中位数 7.17 秒对 247.73 秒,待办题 23.32 秒对 395.20 秒。第三项整理订单,两边都没能完整交付。
但把 24 道题放在一起按整题判定,Qwen 通过的题更多:Spark 8 道,Qwen 16 道。
| 判据 | Spark-X2.5-4B | Qwen3.6-35B-A3B |
|---|---|---|
| 三项主任务完成 | 2 项(说明书、待办) | 2 项(说明书、待办) |
| 主任务成功等待(中位数) | 7.17 秒 / 23.32 秒 | 247.73 秒 / 395.20 秒 |
| 24 道题最终通过 | 8 / 24 | 16 / 24 |
「完成 2 项」只按预定三道主任务、且允许题目规定的最多两次返工来算, 不把补充题或重复跑到的一次成功塞进这个数字。重复是为了看稳定性,不增加题目数。
2. 测试环境:两台模型是怎么跑起来的
| 项目 | 配置 |
|---|---|
| 笔记本 | RTX 3060 Laptop GPU,6 GB 显存;i7-12700H;64 GB 系统内存 |
| 推理 | llama.cpp,两模型同一 commit 96550613 |
| Spark-X2.5-4B | Spark-X2.5-4B-Q4_K_M.gguf,2 600 224 352 字节(约 2.42 GiB),全部层放 GPU |
| Qwen3.6-35B-A3B | Qwen3.6-35B-A3B-UD-Q4_K_XL.gguf,22 360 456 160 字节(约 20.83 GiB),40 层专家在 CPU |
| 共同参数 | 32K 上下文、greedy(temp 0 / top_p 1 / top_k 0)、关闭思考、单并发、20 线程 |
| 运行方式 | 每个任务新起一次服务进程,加载时间单独计,不计入任务耗时 |
Qwen 那一路的 35B 是总参数量,每生成一个 token 大约只激活 3B 参数。它的权重装不进 6 GB 显存,靠 -ncmoe 40 把 40 层专家计算交给 CPU,再由系统内存供权重——这也是它慢下来的主要原因。
两个模型的量化级别并不相同(Q4_K_M 对 UD-Q4_K_XL),架构也不同。 这是一次同一台电脑上的实用比较,不是控制变量的量化或参数量实验, 不能读成「4B 比 35B 强」或「6 GB 显存能单独装下 35B」。
3. 判分口径:24 道题、每轮预算与返工规则
题库冻结在 laptop-task-v2,共 24 道英文任务:订单与数据整理、说明书问答、浏览器修复各 8 道,其中 18 道常规题、6 道加长或更复杂的压力题。每个模型各跑一遍,固定题目顺序、两边交替先后。
首答只有在完整输出、并且结构、事实、引用或全部浏览器行为检查都通过时才算通过;部分正确只记部分检查数,整题不通过。未通过可以追加最多两次固定反馈,反馈只说哪里失败、不给答案。超时、连接中断或输出被截断都算该轮未完成,不能拿可见前缀判通过。
| 题型 | 每轮输出上限 | 每轮墙钟上限 |
|---|---|---|
| 订单整理(常规) | 2048 tokens | 300 秒 |
| 说明书问答(常规) | 1024 tokens | 600 秒 |
| 浏览器修复 | 4096 或 8192 tokens | 900 秒 |
| 压力题 | 按 cases.json 逐题登记 |
900 秒 |
预定主任务 DATA-001、DOC-005、CODE-001 各模型各完整跑 5 次,防止测完只挑有利的题;其余 21 道各跑 1 次。合计 48 次首轮对照加 24 次重复,共 72 个 run,全部完成。
4. 主任务一 · 说明书三问:两边全对,等待差 34 倍
给同一份约 7 500 词的英文说明书,只根据原文回答三个问题,并且指出答案出处。两边 5 次全部首次通过,三个答案和出处都对:
| 问题 | 正确答案 |
|---|---|
| 例行维护什么时候开始,最长中断多久? | C 窗口 · 02:30 UTC,最多 18 分钟 |
| 4.2 版受限文件的体积和附件数上限? | 每个 8 MiB,最多 6 个附件 |
| 中断之后保证退款多少? | 说明书没有规定 |
第三问是关键:两台模型都没有编一个金额出来。
| 模型 | 结果 | 成功等待(中位数,5 次) |
|---|---|---|
| Spark-X2.5-4B | 5/5 首次通过 | 7.17 秒 |
| Qwen3.6-35B-A3B | 5/5 首次通过 | 247.73 秒 |
说明书是本次实验用的虚构测试材料,不是任何厂商的真实文档; 数字来自各 run 的原始记录,不从录像或截图估算。 耗时为「发送请求到核对完成」的中位数,不含模型加载。
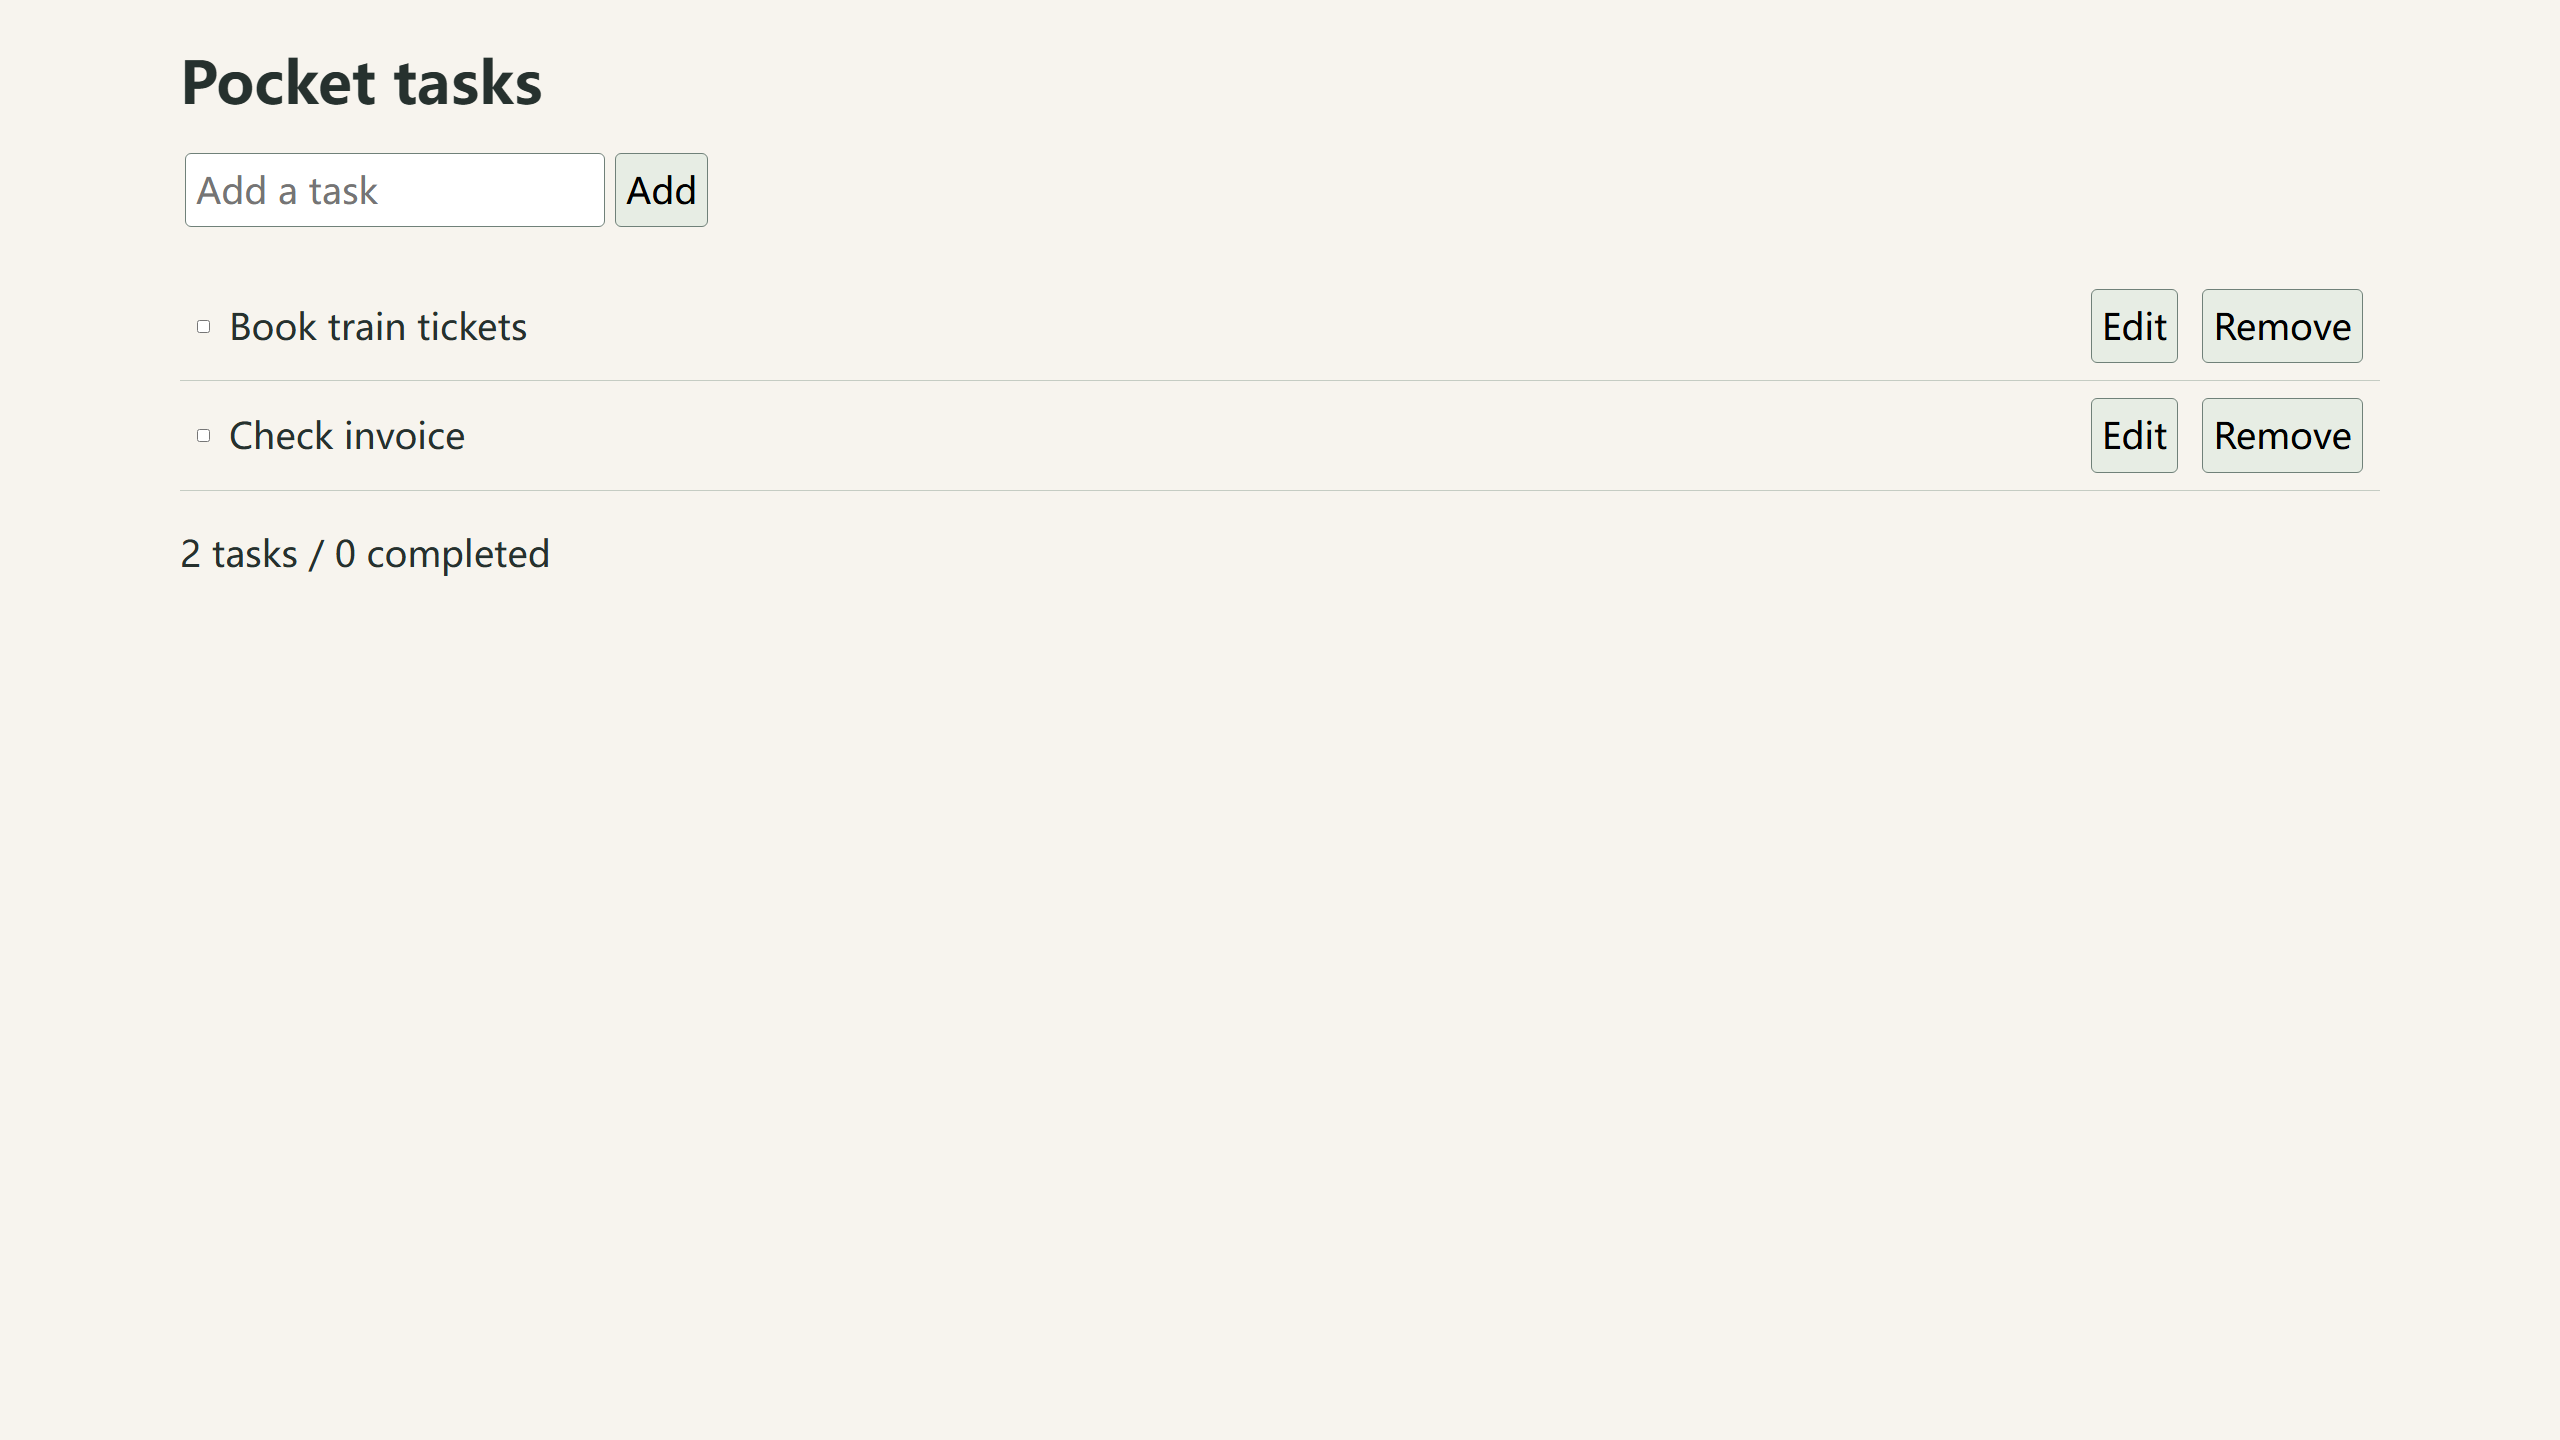
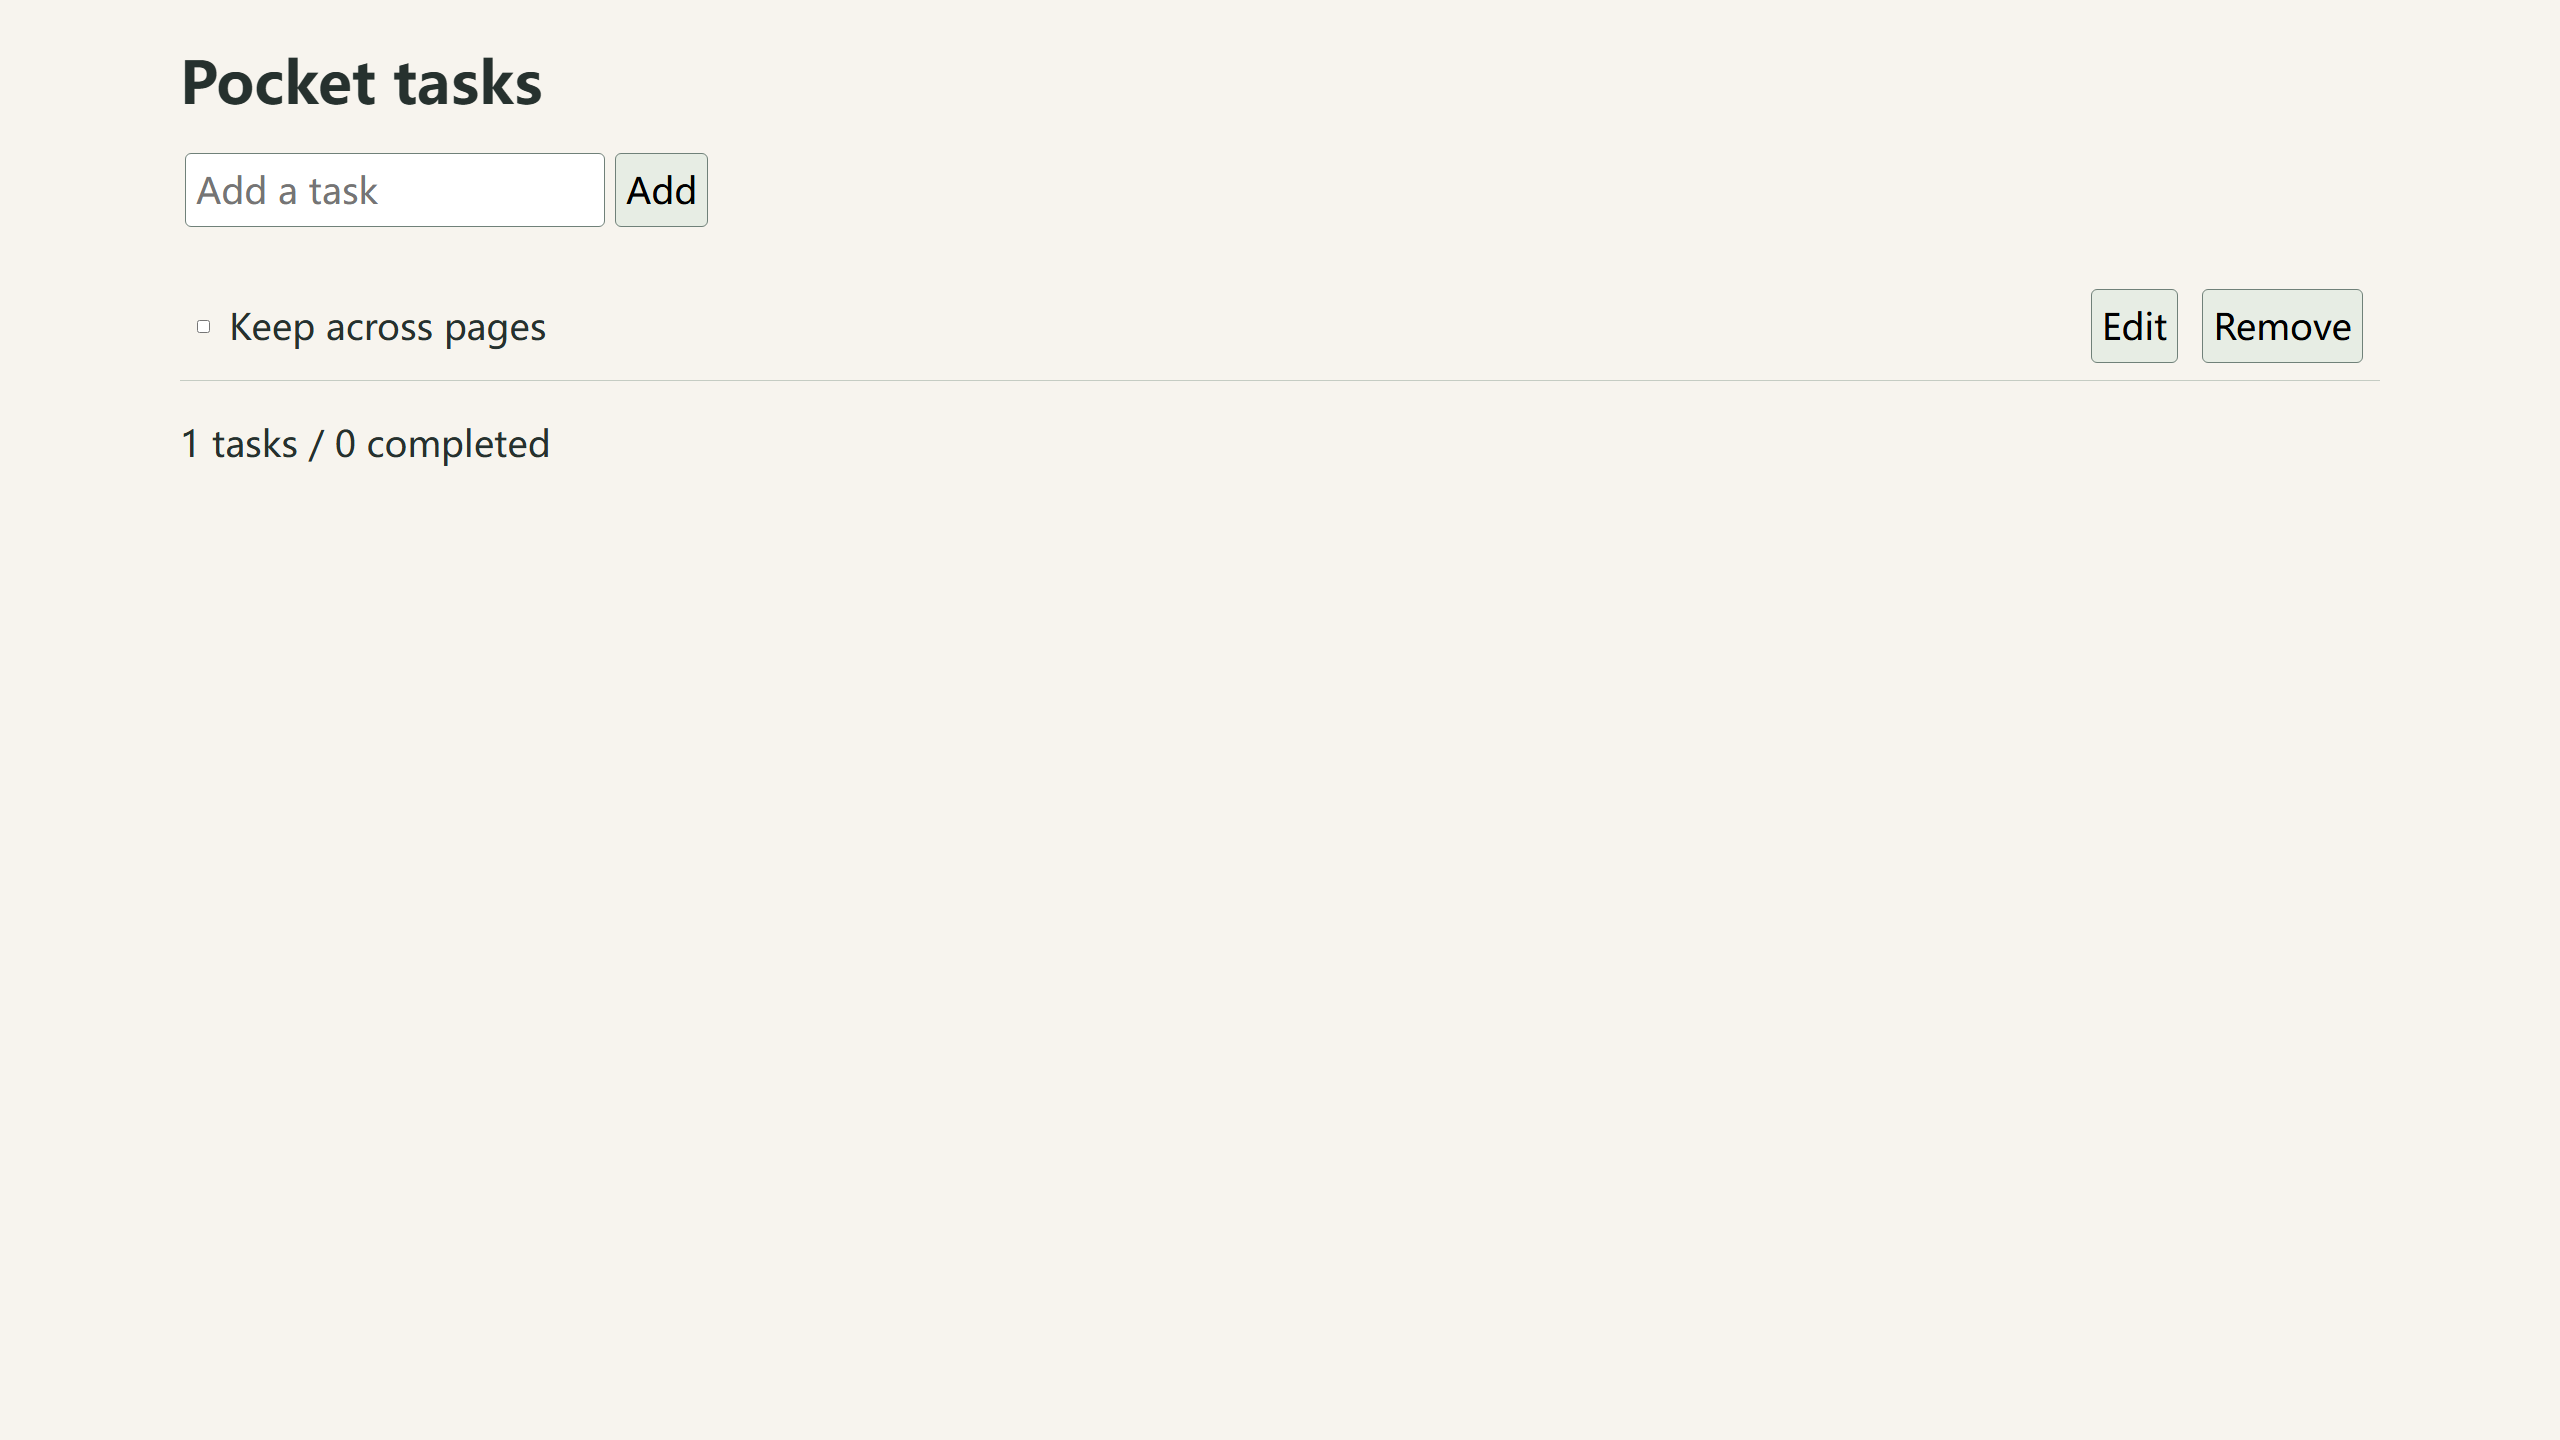
5. 主任务二 · 待办清单刷新持久化:两边都修好
题面给一个坏掉的单文件待办网页:新增的条目刷新就消失。要求让添加、编辑、勾选、删除都能保存,然后打开网页实际操作验证。
两边 5 次全部首次通过、无需返工;验收不只截图,还包括实际点击与刷新、重新打开页面。检查还覆盖了「删掉最后一条之后刷新仍然为空」这种边界情况。
| 模型 | 结果 | 成功等待(中位数,5 次) |
|---|---|---|
| Spark-X2.5-4B | 5/5 首次通过 | 23.32 秒 |
| Qwen3.6-35B-A3B | 5/5 首次通过 | 395.20 秒 |
任务耗时包含自动保存与浏览器验收这一套固定流程, 不等于人手工粘贴再核对的实际耗时,两方用的是同一套流程。
6. 主任务三 · 订单整理:两边都没完整交付
把杂乱的订单信息整理成表格:只算已付款,逐笔核对商品、数量、运费和总额。其中一笔 JB-101 的正确合计是 $30.40。
| 模型 | 5 次结果 | 失败实耗(中位数) | 实际表现 |
|---|---|---|---|
| Spark-X2.5-4B | 0/5 | 33.36 秒 | 首答写 $29.40,少算 $1,还漏掉 JB-102;返工后整题仍未通过 |
| Qwen3.6-35B-A3B | 0/5 | 300.35 秒 | 到 300 秒生成上限时回答仍没写完 |
两边 5 次都没能完整交付全部 6 笔订单。Spark 结束得快,但金额和漏单仍要人工核对。
表里的秒数是失败实耗,不是「做对所需时间」——这两题两边都没有成功 run, 所以没有成功等待可以报。失败耗时只说明它花了多久才失败,不能当成性能成绩。
7. 补充题 · 引用必须给全:答案对,出处也要全
在约 1.6 万词的说明书里找地区规则:南区工单保留多久、归档申请交给谁、HOLD 状态有什么例外。需要找的规则是:普通工单 45 天、HOLD 工单 365 天,归档申请交给 GRAY 团队,归档前由归档负责人审批;归档取回的费用资料里没写,两边都没有编造。
| 模型 | 结果 |
|---|---|
| Spark-X2.5-4B | 事实全部答对,但漏了「GRAY 团队」这条的出处;返工 2 次仍未补齐 |
| Qwen3.6-35B-A3B | 首次通过:规则、例外和出处都找全了 |
这题 Spark 的问题在引用不全,不能说它把保留天数读错了。
8. 补充题 · 筛选后删除:Spark 删错了另一条
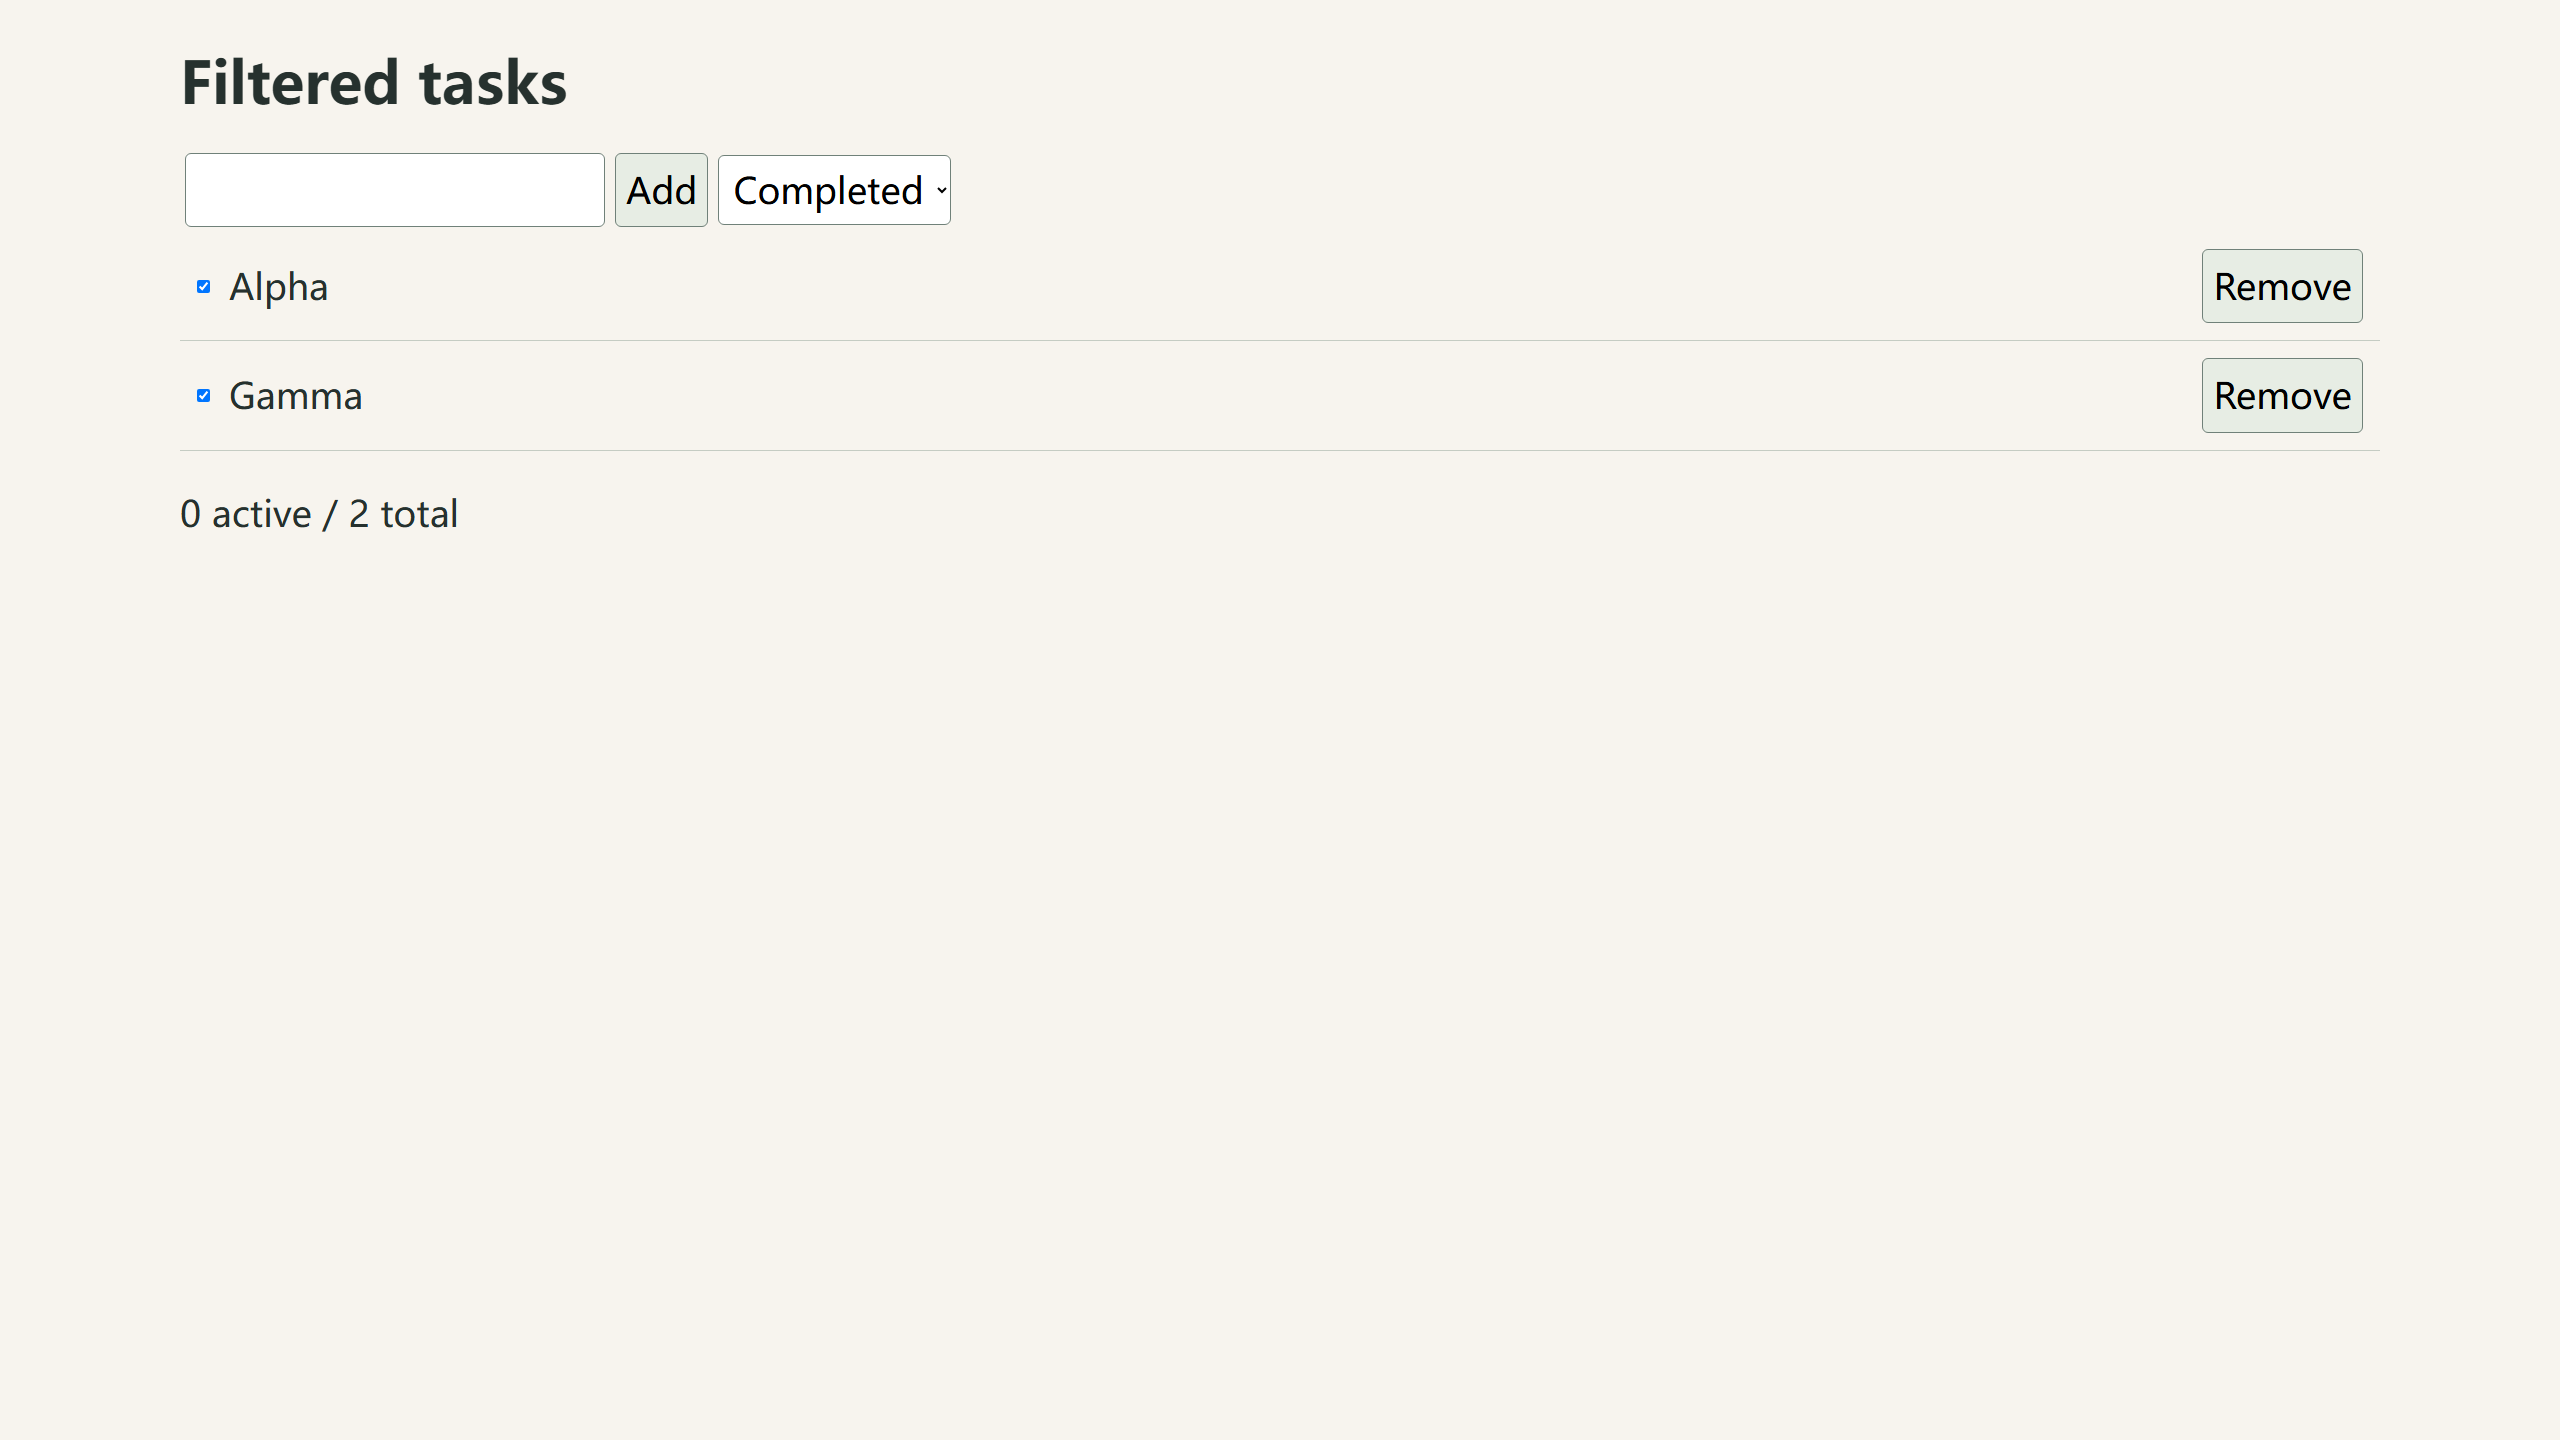
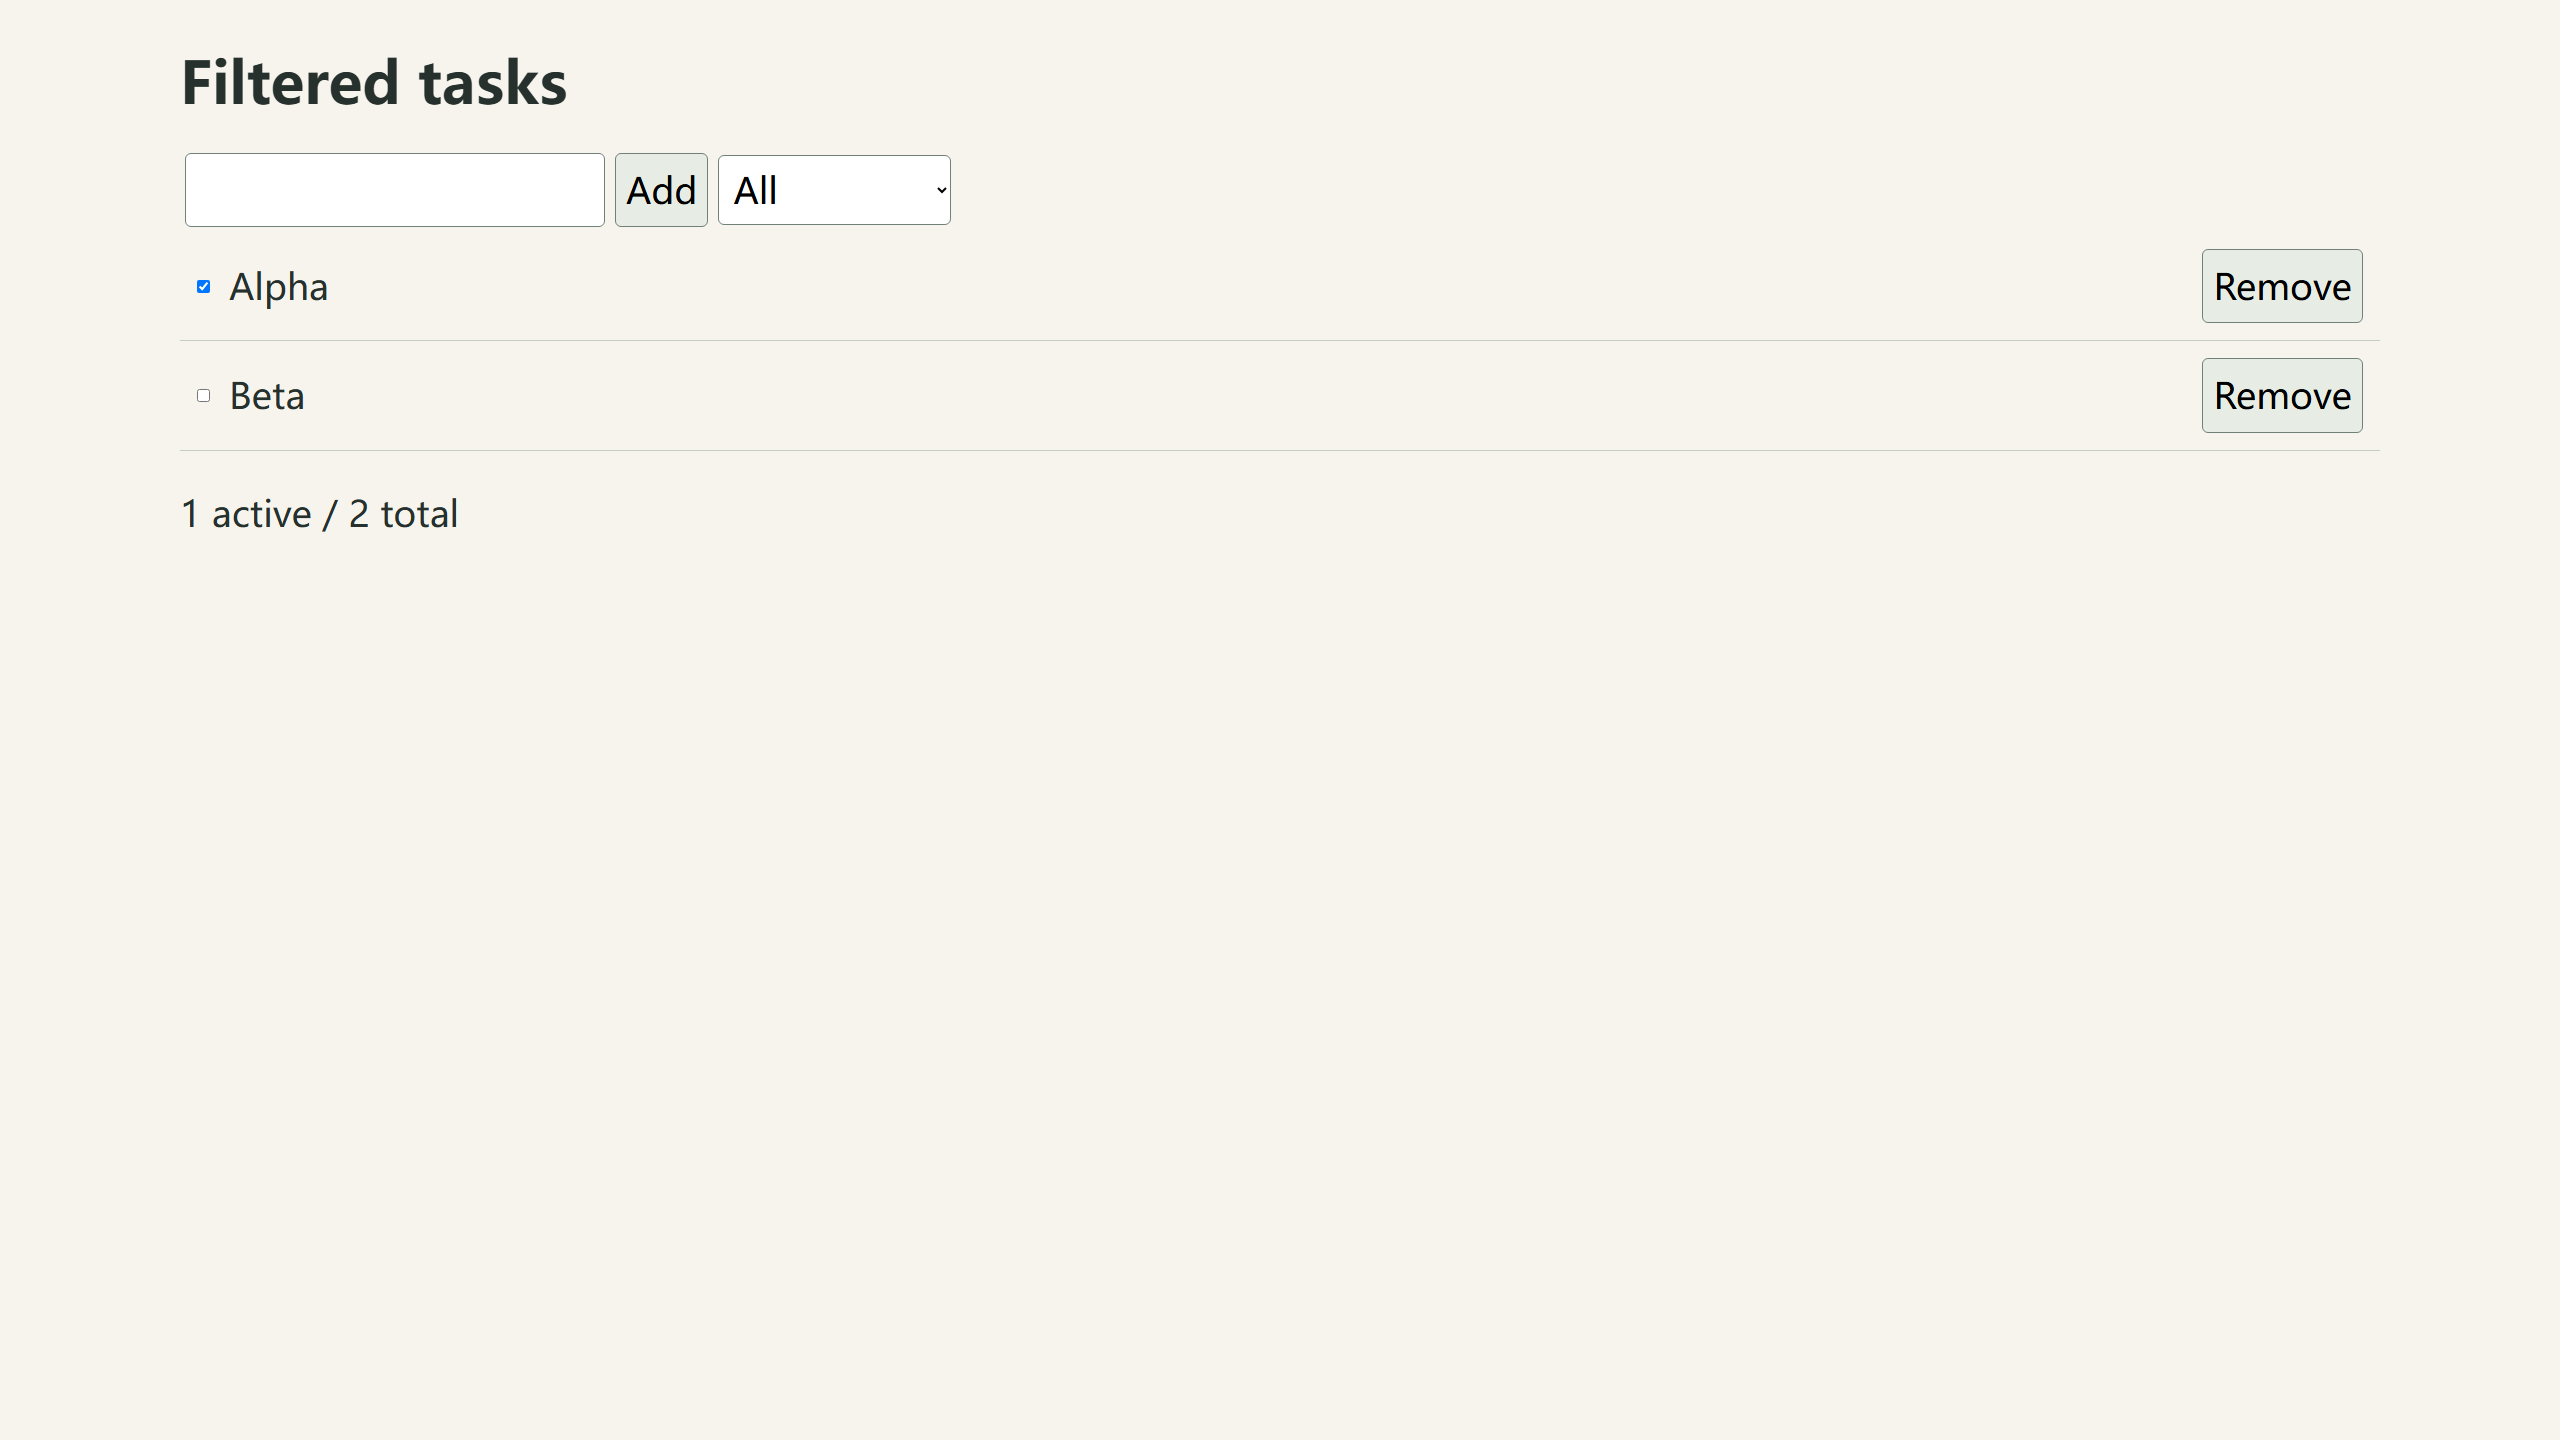
已完成的是 Alpha、Gamma,未完成的是 Beta。在「已完成」筛选视图里删除 Gamma,应该留下 Alpha 和 Beta。
| 模型 | 结果 |
|---|---|
| Spark-X2.5-4B | 返工 2 次后仍失败:已完成视图留下 Alpha 和 Gamma,误删了未完成的 Beta |
| Qwen3.6-35B-A3B | 首次通过:删除对象正确,刷新后的全部视图留下 Alpha 和 Beta |
同样是「改一个待办网页」,多一层筛选之后结果就分开了。这也是为什么待办那道主任务通过,不能直接推断这一道也会过。
9. 补充题 · 发票修订与跨时区汇总
修订发票:同一张发票有多个版本,以最高修订版为准,重复只算一次,只汇总已付款。其中 IN-302 的新版已付款、5 件 × $7.20、运费 $2,这笔应计入 $38.00(整题完整正确合计 $155.20)。
| 模型 | 首次回答 | 修改之后 |
|---|---|---|
| Spark-X2.5-4B | 写成 $362 | 返工 2 次,仍是 $362 |
| Qwen3.6-35B-A3B | 漏掉这张发票 | 返工 1 次,整题通过 |
跨时区汇总:把不同地区的付款按 UTC 日期汇总,取消的记录不算。其中一笔 EV-01 是当地 9 月 10 日 23:30、时区 UTC−4,换算成 UTC 应是 9 月 11 日 03:30。
| 模型 | 首答如何分组 | 整题最终结果 |
|---|---|---|
| Spark-X2.5-4B | 放进 9 月 10 日 | 返工 2 次,未通过 |
| Qwen3.6-35B-A3B | 放进 9 月 10 日 | 返工 2 次,未通过 |
Qwen 在这题的总金额 $43.50 算对了,但分组日期错了。只核对最后一个总数,就会漏掉这个问题。
10. 特殊笔记:两边都保留了原样
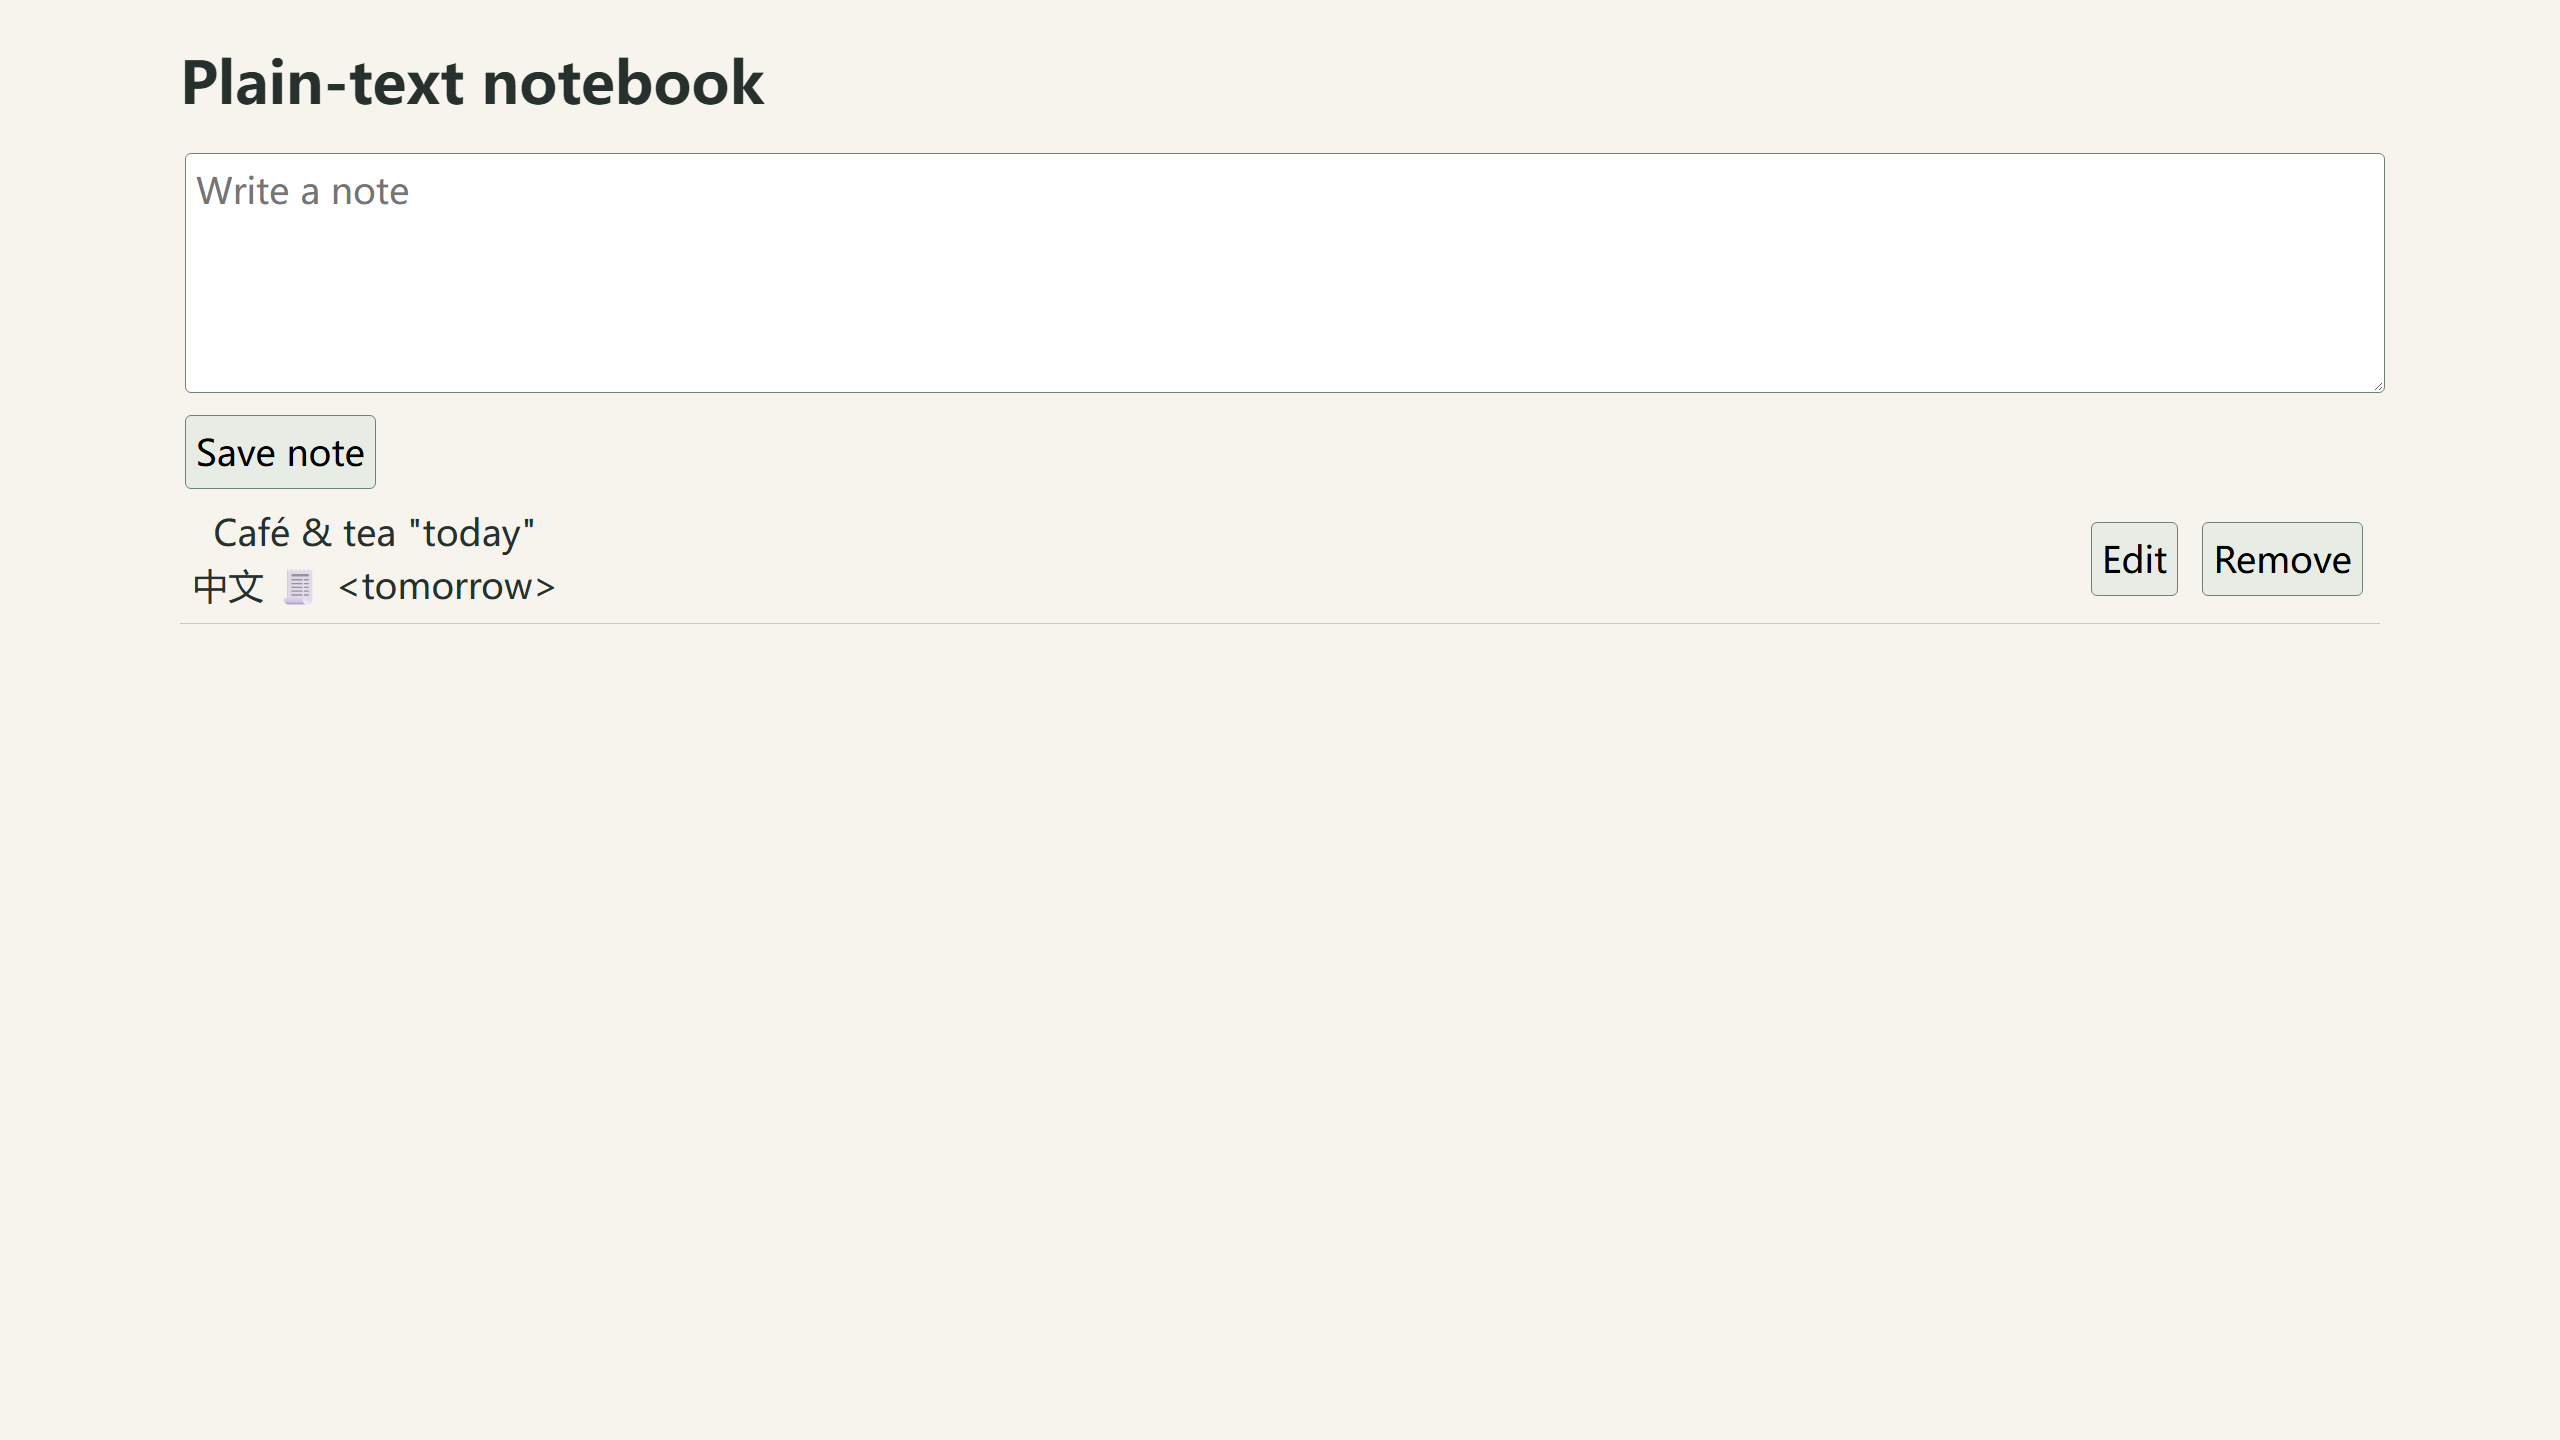
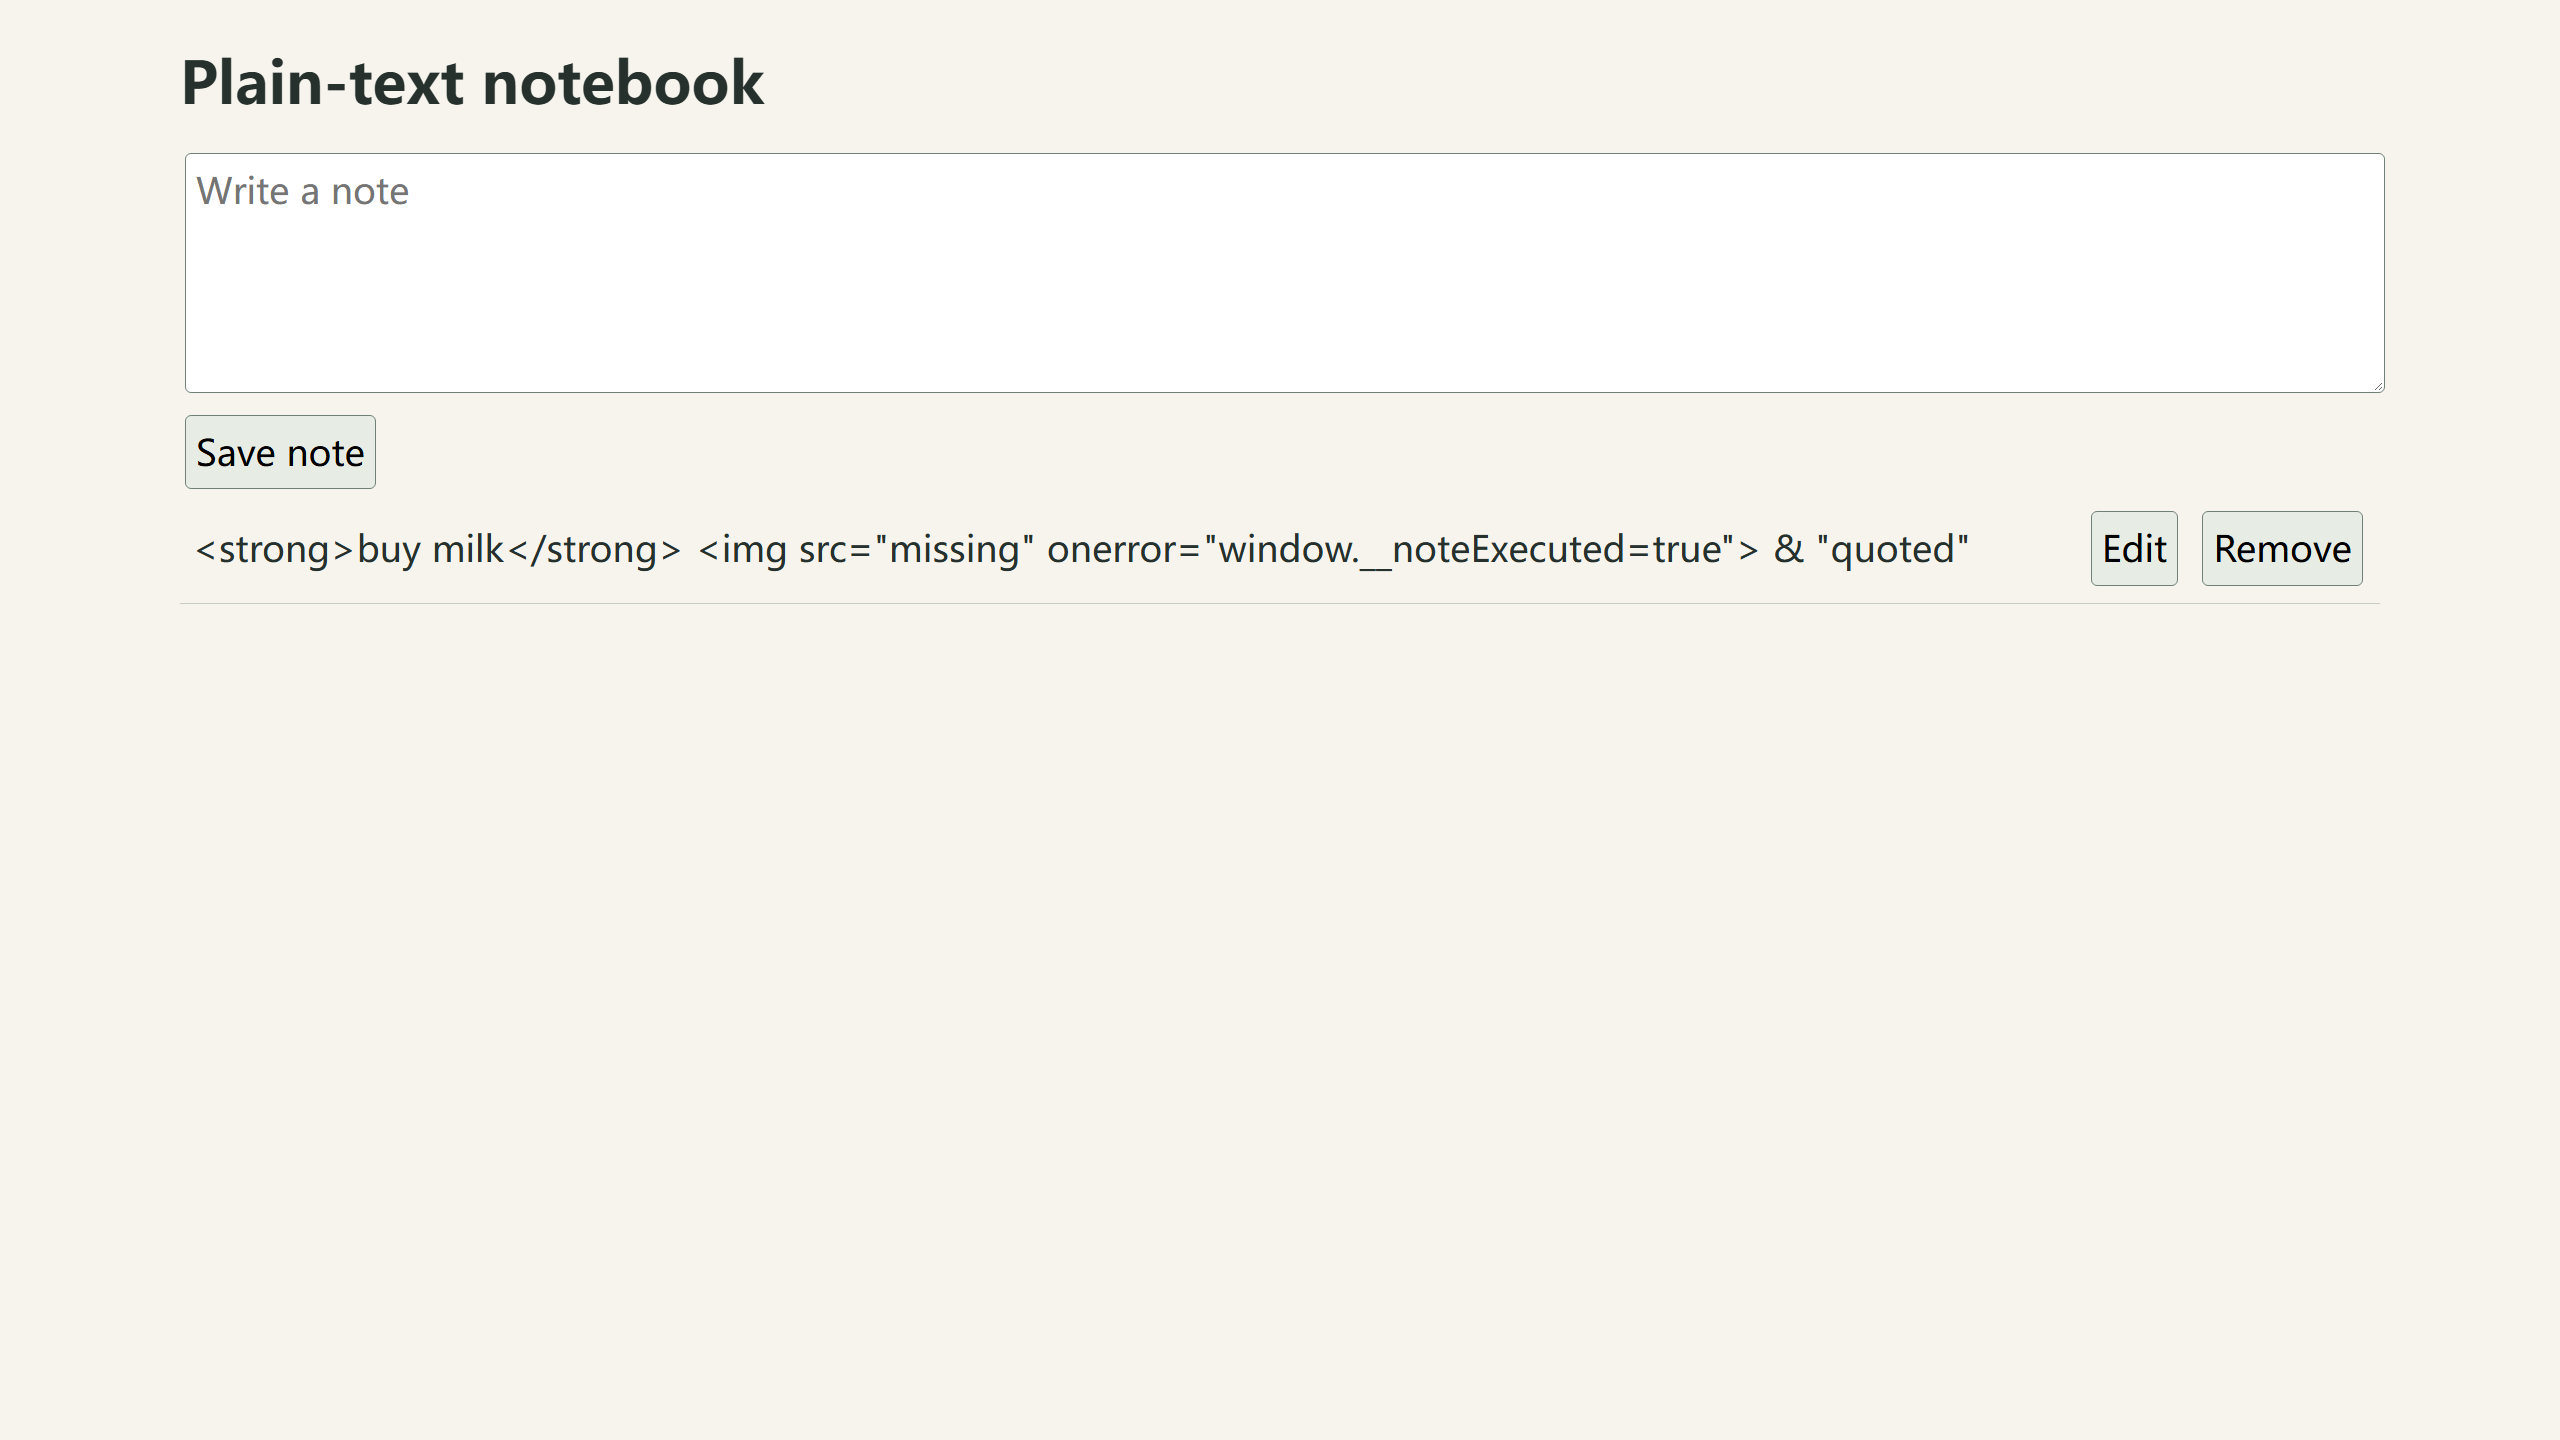
修复一个纯文本笔记网页:保存、编辑、刷新之后,字符、空格和换行都不能变。两边第一次生成的网页都通过了全部四项检查。
| 检查重点 | Spark-X2.5-4B | Qwen3.6-35B-A3B |
|---|---|---|
| 中文、引号、emoji 原样保留 | 通过 | 通过 |
| 空格与换行不丢失 | 通过 | 通过 |
| 标签样文字不变成网页元素 | 通过 | 通过 |
| 纯空白不保存,编辑后仍正确 | 通过 | 通过 |
11. 完整 24 题结果:Qwen 通过得更多
同样的修改机会之后,看各自有多少道题能完整交付。
| 分组 | Spark-X2.5-4B | Qwen3.6-35B-A3B |
|---|---|---|
| 18 道常规题 | 8 / 18 | 13 / 18 |
| 6 道压力题 | 0 / 6 | 3 / 6 |
| 合计 | 8 / 24 | 16 / 24 |
Spark 有更快做对的任务,Qwen 有更多做对的题目。两项主任务(说明书、待办)是两边共同的得分点;真正的差距出现在引用完整度、以及加长或更复杂的题目上。
按 24 道不同题目统计,三道主任务的 5 次重复不增加题数, 所以这里的分母是 24,不是 72。每题允许最多两次返工,超时即结束。 压力题单独列出,不与常规题合并宣传成功率。
12. 这台电脑上,我会怎么选
先试 Spark:长文查找、小网页修复。 这两项主任务它都做对了,等待明显更短。能自己快速核对结果的小任务,先交给它比较划算。
愿意多等就上 Qwen: 修订发票、筛选删除、例外规则引用这几道它做得更完整,代价是几十倍的等待。
金额和日期两边都要复核: 订单整理和跨时区汇总都没有完全做好,表格排得整齐也得逐项核对。
结论只适用于本机与本次设置。6 GB 显存之外,这台机器还有 64 GB 系统内存, 换成别的电脑或别的配置需要另测。题目全部为合成测试材料。
13. 复现配置:完整启动命令与共同参数
两个模型除 MoE 层数外,参数完全一致:
# Spark-X2.5-4B:全部层放 GPU,不卸载专家到 CPU
llama-server -m Spark-X2.5-4B-Q4_K_M.gguf \
  --alias spark4b --host 127.0.0.1 --port 8081 \
  -c 32768 -t 20 -tb 20 -b 512 -ub 128 -ngl 99 \
  -fa on -ctk q8_0 -ctv q8_0 -np 1 \
  --jinja --reasoning-format deepseek --no-reasoning-preserve \
  # -c 32K 上下文;-t/-tb 各 20 线程;-ngl 99 全部层上 GPU
  # -fa on FlashAttention;-ctk/-ctv q8_0 KV 缓存量化;-np 1 单并发
  # --reasoning-format 与 --no-reasoning-preserve 关掉思考输出
# Qwen3.6-35B-A3B:多一行 -ncmoe,把 40 层专家计算交给 CPU
llama-server -m Qwen3.6-35B-A3B-UD-Q4_K_XL.gguf \
  --alias qwen35b --host 127.0.0.1 --port 8082 \
  -c 32768 -t 20 -tb 20 -b 512 -ub 128 -ngl 99 \
  -fa on -ctk q8_0 -ctv q8_0 -np 1 \
  --jinja --reasoning-format deepseek --no-reasoning-preserve \
  -ncmoe 40
  # -ncmoe 40 是这两个模型唯一的启动差异:40 层专家的计算放 CPU
两次都追加了 --fit off --no-context-shift --no-cache-prompt --cache-ram 0:关闭上下文移位和提示缓存,保证每轮都是完整历史重算。
| 测量口径 | 说明 |
|---|---|
| 成功等待 | 第一次发送到全部验证通过,取 5 次的中位数,不含模型加载 |
| 失败实耗 | 最终失败的任务实际花了多久,单独列出,不当作完成时间 |
| 模型加载 | 每个任务新起一次进程,从启动到可用的时间另计 |
14. 附录:导出规则题,答对规则、格式返工一次
这题问 3.1 版的导出规则,并要求按题目指定的代号作答:缺失日期要写文字代号 NULL。
| 实际提问(中文简写) | 正确答案 |
|---|---|
| 用什么分隔符和编码? | 制表符 / UTF-8 |
| 日期怎么写?缺失日期用什么代号? | ISO 日期 / NULL |
| 每天最多可以导出多少次? | 说明书未提供 |
Spark 首次通过,规则、出处和指定格式都符合。 Qwen 规则和出处原本就正确,但首答把缺失日期写成了空值,返工 1 次后通过。
Qwen 没有把说明书读错,它需要修改的是回答格式。这一页用来补充说明格式要求,不作为事实答错的例子。