6G 显存笔记本跑 24B:改 -ncmoe,三道真题全对
在 RTX 3060 Laptop(6GB)+ 64GB 内存上,Liquid AI LFM2.5-24B-A2B(Q4_0)可以本地跑通。默认 -ncmoe 40 约 1.3GB 显存;改成 30 后端到端更快,三道真题仍全对——包括 35B 做错的那道算账题。代价是思考链关不掉。
结论
可用条件:系统内存 64 GB,llama.cpp commit 9655061,模型 LFM2.5-24B-A2B-QAD-Q4_0.gguf。主配置 `-ngl 99 -ncmoe 30`(对比基线 `-ncmoe 40`)。
主要限制
- 思考链在本 commit / 模板下关不掉:预检 thinkoff 仍产出 reasoning,首段正文前常见 2–3 分钟等待。
- llama-bench 速率不含分词与采样,不能直接当成聊天端到端速度。
- 只在本机 6GB Laptop + 64GB RAM 验证;更小内存机型需另测。
实验信息
| 硬件 | NVIDIA GeForce RTX 3060 Laptop GPU · 6 GB · laptop · CC 8.6 |
|---|---|
| CPU / RAM | 12th Gen Intel(R) Core(TM) i7-12700H · 64 GB |
| 模型 | LFM2.5-24B-A2B · Q4_0 · moe |
| 框架 | llama.cpp · 9655061 |
| 测试日期 | 2026-10-14T18:00:00+08:00 |
参数交互
在已测过的组合之间切换。未测过的组合显示「暂无实测」—— 不会插值后继续挂实测标签。
本站实测 run_id: LFM-030
| run_id | -ngl | -ncmoe | 上下文深度 | 文本生成 (t/s) | 输入处理 (t/s) | 显存(自身) (MiB) | 运行时长 (s) |
|---|---|---|---|---|---|---|---|
| LFM-030 | 99 | 30 | 默认 | 29.47 | 180.7 | 4491 | 40 |
视频
结果:三道题全对,35B 做错的那道也对了
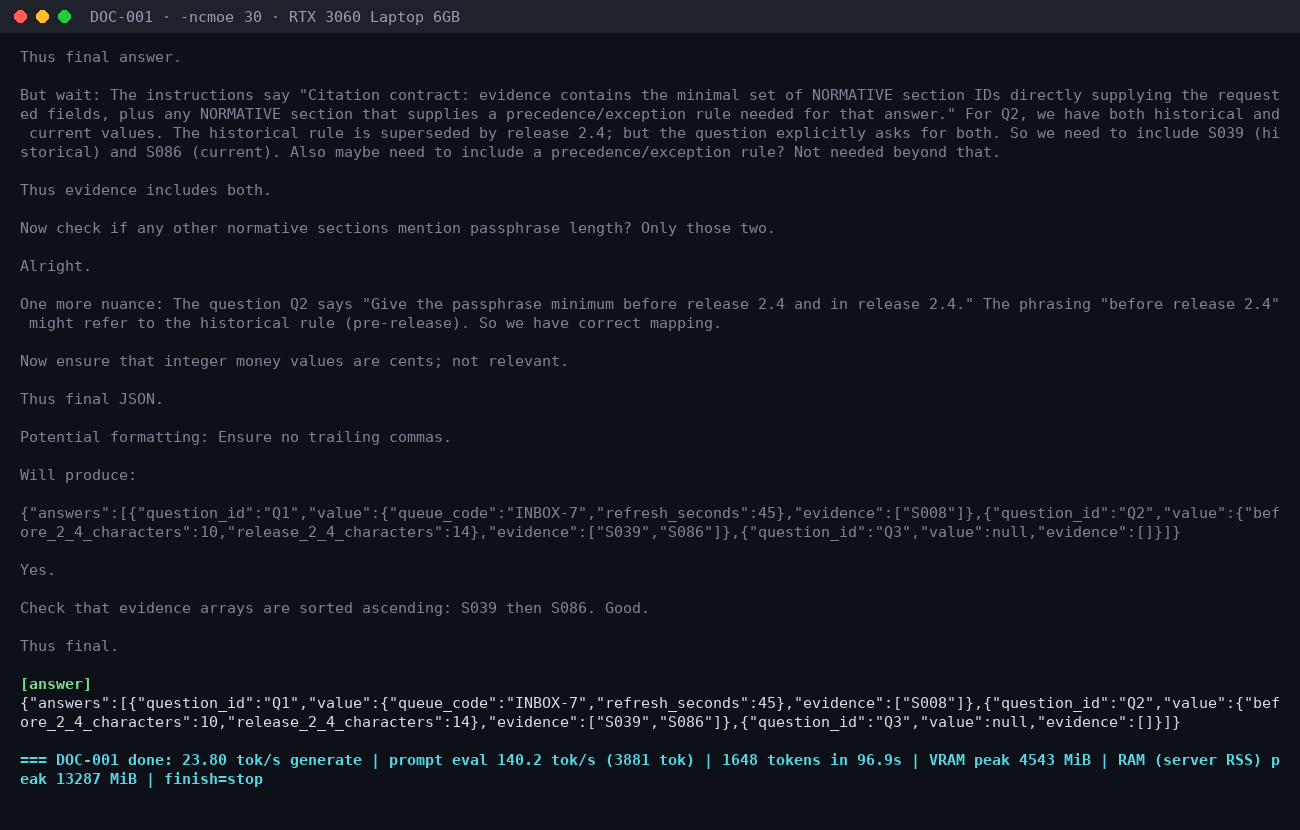
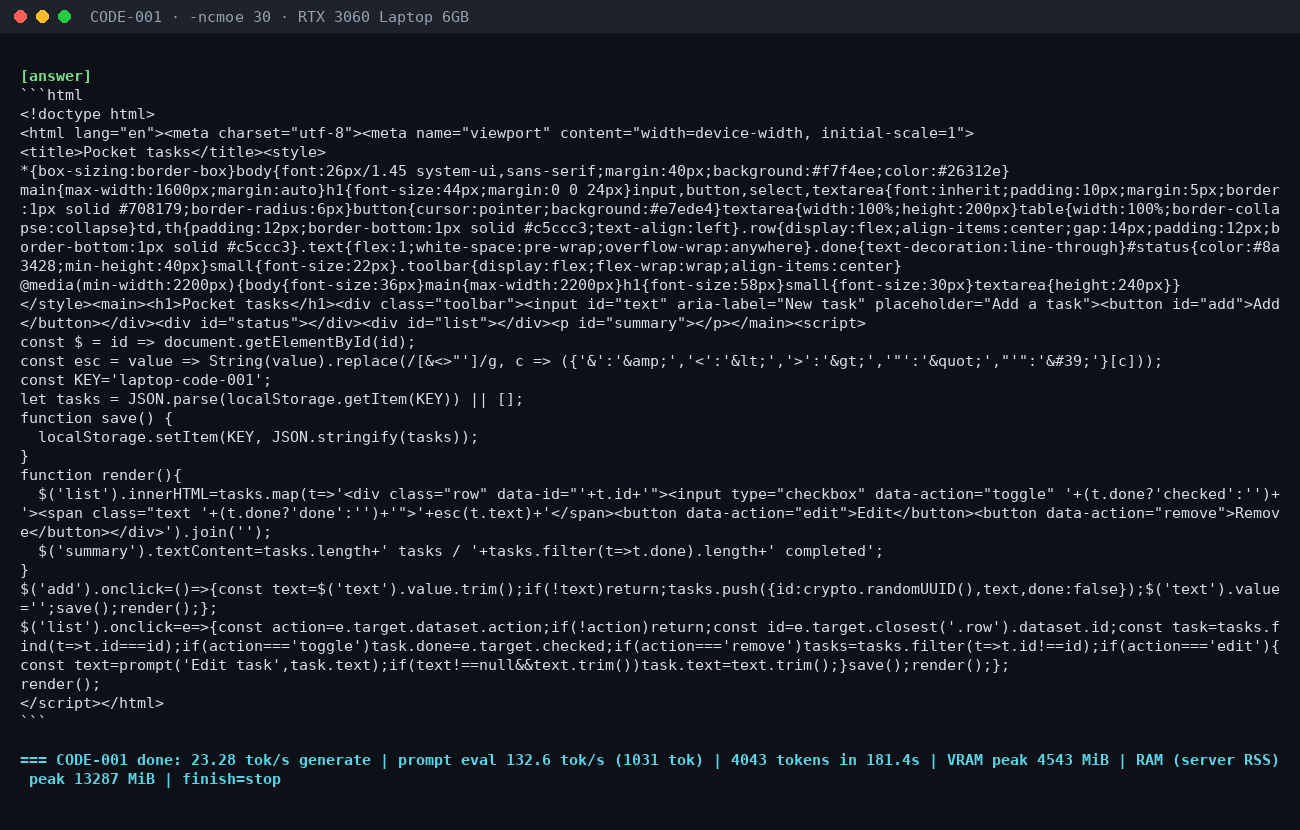
在 NVIDIA GeForce RTX 3060 Laptop GPU(6 GB)+ 64 GB 内存的笔记本上,LFM2.5-24B-A2B(Q4_0)用 -ncmoe 30 跑完三道实测题:写代码(CODE-001)、按 UTC 日期汇总账单(DATA-004)、读长手册答题(DOC-001),三道全部通过。
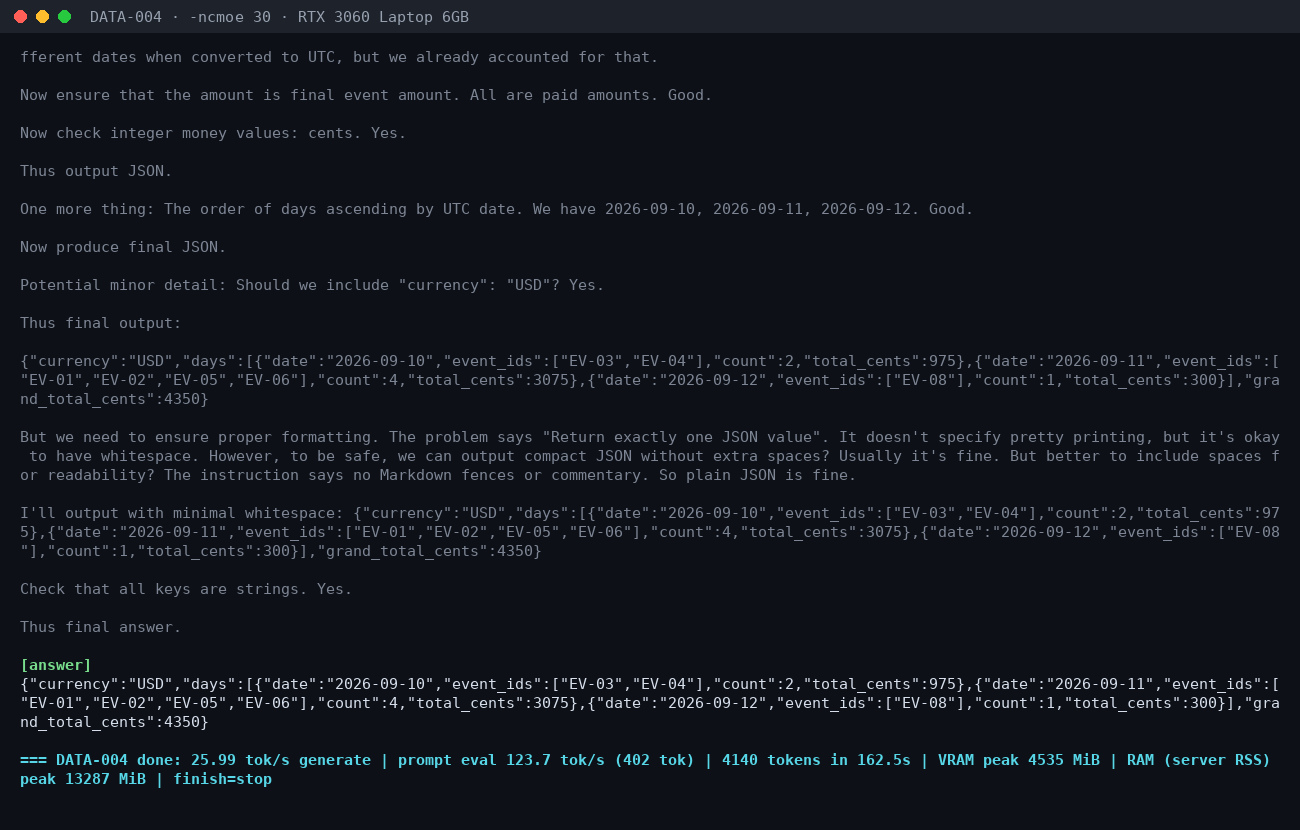
DATA-004 就是之前 35B 实测里做错的那道。这次 24B 给出了正确的 grand_total_cents: 4350。
实录:一道题从开始到答完
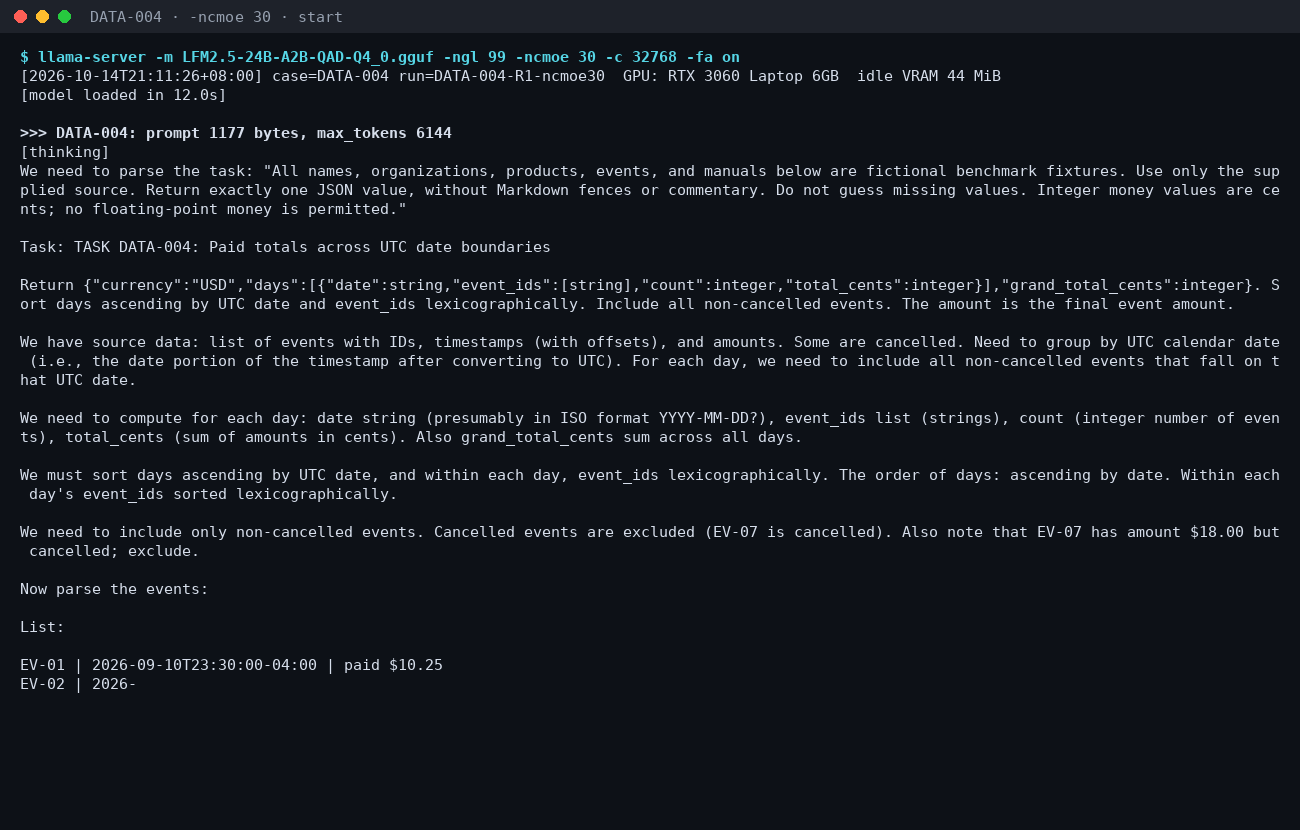
下面是 DATA-004 的真实终端录制,按时间加速约 16 倍:先加载模型,然后是一大段思考,最后输出 JSON 答案和速度、显存统计。
关键一步:-ncmoe 40 → 30
-ncmoe 决定多少层 MoE 专家留在 CPU。默认 40 把专家全放 CPU,显存只用约 1.3 GB;改成 30,让 10 层专家进 GPU,显存涨到约 4.5 GB,仍在 6 GB 以内,速度明显变快。
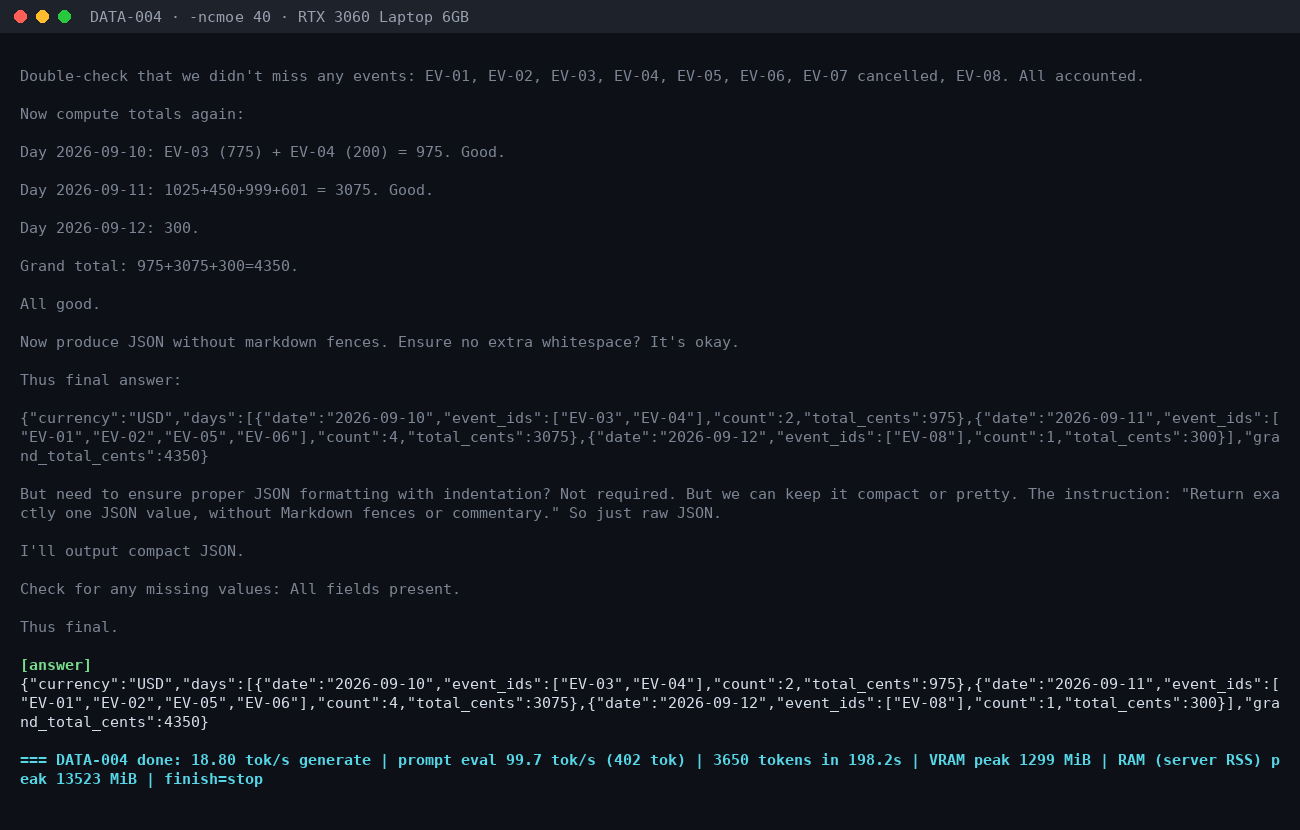
三道题的端到端生成速度(终端最后一行):
            -ncmoe 40     -ncmoe 30
CODE-001    17.73 tok/s   23.28 tok/s
DATA-004    18.80 tok/s   25.99 tok/s
DOC-001     17.98 tok/s   23.80 tok/s
显存峰值     ~1.3 GB       ~4.5 GB
llama-bench 输出(RTX 3060 Laptop · Q4_0 · q8_0 KV · build 9655061,仅保留关键列)(纯生成速率,不含思考和采样开销):
n_cpu_moe    test             t/s
       40   pp512   139.88 ± 3.21
       40   tg128    22.49 ± 2.23
       30   pp512   180.70 ± 2.73
       30   tg128    29.47 ± 4.96
       20   pp512    85.95 ± 0.54
       20   tg128    29.49 ± 0.39
注意:ncmoe 20 时预填充反而掉到约 86 tok/s,所以正文只比较 40 和 30。
另外两道题的答题画面
硬件与命令
笔记本:联想拯救者 Y9000P 2022,NVIDIA GeForce RTX 3060 Laptop GPU 6 GB,i7-12700H,64 GB DDR5
模型:LFM2.5-24B-A2B-QAD-Q4_0.gguf(Liquid AI 官方 GGUF)
llama.cpp commit 9655061
llama-server -m LFM2.5-24B-A2B-QAD-Q4_0.gguf \
  -ngl 99 -ncmoe 30 -fa on -ctk q8_0 -ctv q8_0 \
  -c 32768 -b 512 -ub 128 --jinja --reasoning-format deepseek
结论
6 GB 显存的笔记本能跑 24B,而且好用:只要内存够大(本机 64 GB),专家放 CPU 就能装下。真正值得调的只有一个参数,-ncmoe 从 40 改到 30,速度提升约三成,显存还在预算内。
注意:这个模型在本 commit 下关不掉思考,每道题要先想一两分钟再给答案。