Windows 原生部署 LingBot-World 1.3B:6GB 显存笔记本跑通 13 帧图生视频
从零到出片:记录环境、克隆已打补丁的分支、aria2 多连接下载、CUDA 闸门、13 项权重校验,最后跑出 832×464 的 13 帧图生视频。命令可直接复制,每一步都给出判断标准;上游在 Windows 上会卡住的 flash-attn 问题放在文末说明。
结论
可用条件:Windows 11 x64 + NVIDIA 驱动 + Python 3.12;仓库、依赖、权重与输出放在同一个非系统盘目录里(本文用 F:\AI),回滚就是删目录。
主要限制
- 本教程用已含 SDPA 回退补丁的分支(非官方支持路径);上游原样在 Windows 上装不了 flash-attn,见文末说明
- 显存只有运行中的一次采样读数,不是连续峰值,不能据此比较不同方案的显存占用
- 模型退出码没有回读;未验证更高分辨率、更多帧、多卡、其他显卡与商业使用
实验信息
| 硬件 | NVIDIA GeForce RTX 3060 Laptop GPU · 6 GB · laptop · CC 8.6 |
|---|---|
| CPU / RAM | 12th Gen Intel Core i7-12700H · 64 GB |
| 模型 | LingBot-World 2.0 i2v-1.3B · F32 权重,加载时转 bfloat16 · 图生视频(DiT 1.3B + T5 + VAE) |
| 框架 | Windows 11 原生 · PyTorch 2.11.0+cu128 · 本机 SDPA 回退补丁 · 1895d30 |
| 测试日期 | 2026-10-05T12:10:57+08:00 |
视频
准备:环境、目录与前置条件
这篇记录在一台 6GB 显存的 Windows 笔记本上,把 LingBot-World 2.0 的 i2v-1.3B 最小图生视频路径跑通的全过程。命令可以直接复制,每一步都给出判断标准。
用哪个仓库:模型与代码的上游是 robbyant/lingbot-world-v2(许可见文末)。上游代码在 Windows 上装不了 flash-attn,直接跑会停在安装这一步;本教程用的是已经加好 Windows 部署改动的仓库:
https://github.com/nonpricklycactus/lingbot-world-v2克隆默认分支就行(改动都在默认分支里):上游代码(基础提交 1895d300d8ac936401689b26389f51cbd36530eb)+ SDPA 回退补丁 + deploy/ 下的部署手册、分步执行器、补丁验证记录和一份 Windows 依赖清单。
前置条件:Windows 11 x64;NVIDIA 显卡驱动;Git;FFmpeg 与 FFprobe;Python 3.12 x64(官网安装器,或本机已有的 uv 提供的 3.12);磁盘留 20 GB 以上,不要放在系统盘。
目录约定:仓库、依赖、权重和输出都放在同一个根目录,回滚就是删掉这一个目录:
F:\AI\lingbot-world-v2     仓库与虚拟环境
F:\AI\models              权重与共享资源
F:\AI\runtime             下载缓存(uv / pip / 轮子)
F:\AI\lingbot-output      输出视频
提示:盘符可以换,但后面所有命令里的变量要一起换;换盘只改 $Root 一处。
本文所用的机器:NVIDIA GeForce RTX 3060 Laptop GPU,6144 MiB 显存;系统内存 63.73 GiB;Windows 版本与驱动见「实验信息」。
逐步执行:从克隆到出片
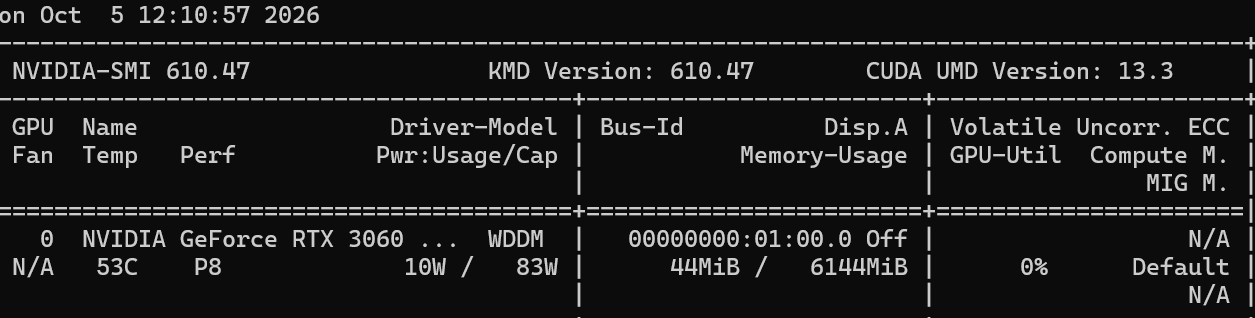
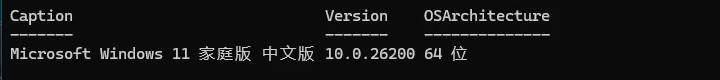
步骤 1 · 记录机器与工具版本。先留下现场,后面每一步都能对照:
nvidia-smi
Get-CimInstance Win32_OperatingSystem | Select-Object Caption,Version,OSArchitecture
Get-CimInstance Win32_ComputerSystem | Select-Object Manufacturer,Model,@{N='RAM_GiB';E={[math]::Round($_.TotalPhysicalMemory/1GB,2)}}
Get-Command nvidia-smi,git,ffmpeg,ffprobe | Select-Object Name,Source
Get-PSDrive -PSProvider FileSystem | Select-Object Name,Free
判断标准:GPU 名称、显存总量、驱动版本、系统版本、内存和目标盘剩余空间都看得见。
步骤 2 · 取代码。用带改动的仓库,克隆完当场确认补丁在里面:
$Root = 'F:\AI\lingbot-world-v2'
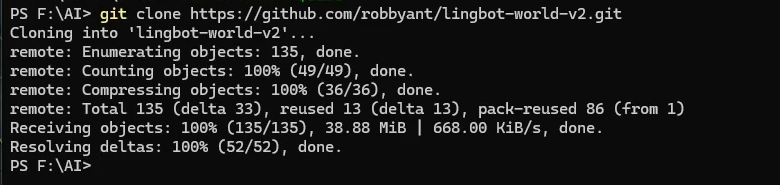
git clone https://github.com/nonpricklycactus/lingbot-world-v2.git $Root
Set-Location $Root
git log --oneline -1
Select-String -Path wan\modules\attention.py -Pattern '_sdpa_varlen_attention' | Select-Object -First 1
判断标准:克隆成功,最后一条命令能查到 _sdpa_varlen_attention —— 说明 SDPA 回退实现已经在仓库里(它就是让这条路径在 Windows 上能跑的原因)。
步骤 3 · 建虚拟环境。把缓存也指到同一个盘里,别让几 GB 的轮子堆到系统盘。用官网安装器装 Python 的读者,把 $Py 换成 python,后面完全一样:
Set-Location $Root
$env:UV_CACHE_DIR = 'F:\AI\runtime\uv-cache'
$env:PIP_CACHE_DIR = 'F:\AI\runtime\pip-cache'
$Py312 = (uv python find 3.12).Trim()
& $Py312 --version
$Venv = Join-Path $Root '.venv'
uv venv --python 3.12 --seed $Venv
$Py = Join-Path $Venv 'Scripts\python.exe'
& $Py --version
& $Py -m pip --version
注意:Microsoft Store 的 python 只是占位程序,装依赖和建 venv 都会失败;版本过新的解释器也可能和 PyTorch 的 Windows 轮子对不上。
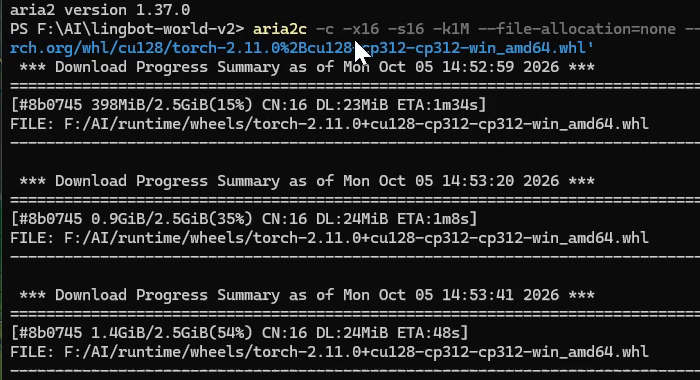
步骤 4 · 装依赖。torch 的 Windows 轮子接近 3 GB,单连接很慢:先用 aria2 多连接抓到本地,再让 pip 装这个本地文件,然后照仓库里的 Windows 依赖清单装其余依赖:
$Whl = 'F:\AI\runtime\wheels'
New-Item -ItemType Directory -Force $Whl | Out-Null
aria2c -c -x16 -s16 -k1M --file-allocation=none -d $Whl -o 'torch-2.11.0+cu128-cp312-cp312-win_amd64.whl' 'https://download.pytorch.org/whl/cu128/torch-2.11.0%2Bcu128-cp312-cp312-win_amd64.whl'
& $Py -m pip install --progress-bar off "$Whl\torch-2.11.0+cu128-cp312-cp312-win_amd64.whl"
& $Py -m pip install --progress-bar off torchvision
& $Py -m pip install --progress-bar off -r deploy\requirements-windows.txt
deploy\requirements-windows.txt 是本分支维护的清单:已经带上 einops(上游清单漏了它,而模型代码要用),也没有 flash_attn(它在 Windows 上装不了)。
判断标准:& $Py -m pip list 里能看到 torch 2.11.0+cu128、transformers、diffusers、einops 等。
步骤 5 · 过 CUDA 闸门:
& $Py -c "import torch; print('torch:', torch.__version__); print('cuda_available:', torch.cuda.is_available()); print('torch_cuda:', torch.version.cuda); print('gpu:', torch.cuda.get_device_name(0) if torch.cuda.is_available() else 'no CUDA')"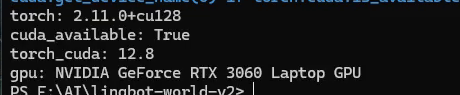
判断标准:cuda_available 为 True、torch_cuda 为 12.8、卡名读得出来。驱动自带的 CUDA UMD 可能是别的版本(本机是 13.3),和 PyTorch 编译用的 12.8 不是同一层东西,两者并存不代表冲突。
步骤 6 · 下载权重并校验。1.3B 包主要是 DiT 权重,T5、VAE 和 tokenizer 从 14B 资源里复用;只取需要的文件,不要拉 14B 本体:
& $Py -m pip install 'huggingface_hub[cli]'
$Hf = Join-Path $Venv 'Scripts\hf.exe'
$Models = 'F:\AI\models'
& $Hf download robbyant/lingbot-world-v2-1.3b-causal-fast --revision 7e36a5f919f86cb4255cc9bfc30adb44963fbde1 --local-dir "$Models\downloads\lingbot-world-v2-1.3b-causal-fast"
& $Hf download robbyant/lingbot-world-v2-14b-causal-fast --revision 5c33dd40b213598c418fd25bff30fdbd23fd38a7 --local-dir "$Models\lingbot-world-v2-14b-assets" --include 'Wan2.1_VAE.pth' --include 'models_t5_umt5-xxl-enc-bf16.pth' --include 'google/umt5-xxl/*'
判断标准:六个 DiT 分片加 index、T5、VAE 和四个 tokenizer 文件都在,并且逐个核对 SHA-256(期望值在 deploy/patch/ 与 01-实验/2026-10-05_lingbot-deploy-windows/model.json 里)。本次实测这 13 项全部匹配。
步骤 7 · 跑 13 帧:
Set-Location $Root
$Dit = Join-Path $Models 'downloads\lingbot-world-v2-1.3b-causal-fast'
$Assets = Join-Path $Models 'lingbot-world-v2-14b-assets'
$Image = Join-Path $Root 'examples\03\image.jpg'
$ActionPath = Join-Path $Root 'examples\03'
$Out = 'F:\AI\lingbot-output\lingbot-13f.mp4'
New-Item -ItemType Directory -Force (Split-Path $Out -Parent) | Out-Null
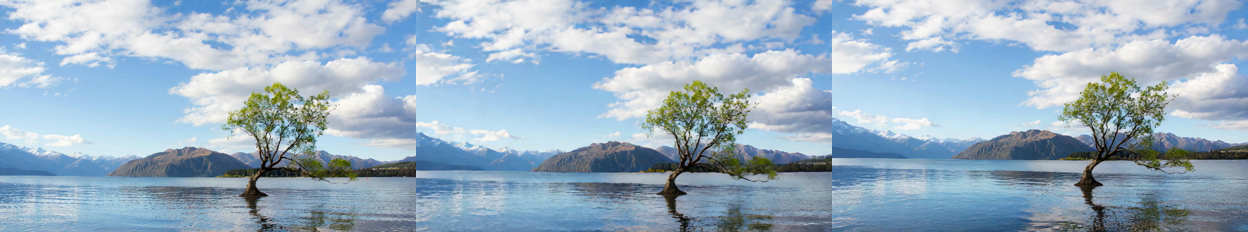
$RunArgs = @('generate.py','--task','i2v-1.3B','--infer_mode','causal_fast','--size','480*832','--frame_num','13','--ckpt_dir',$Dit,'--assets_dir',$Assets,'--image',$Image,'--action_path',$ActionPath,'--t5_cpu','--convert_model_dtype','--offload_model','True','--local_attn_size','18','--sink_size','6','--base_seed','42','--prompt','A serene lakeside scene with a lone tree standing in calm water, surrounded by distant snow-capped mountains under a bright blue sky with drifting white clouds.','--save_file',$Out)
& $Py @RunArgs
判断标准:终端里先出现加载日志,再看到 INFO: Generating video 和进度条,最后出现 INFO: Saving generated video 与 INFO: Finished.。长等待在剪辑里要明示加速,真实耗时看日志时间戳。
步骤 8 · 验收输出。文件存在不等于生成成功,至少留退出码、非零大小、SHA-256 和 ffprobe:
Get-Item -LiteralPath $Out | Format-List FullName,Length,LastWriteTime
Get-FileHash -LiteralPath $Out -Algorithm SHA256
ffprobe.exe -v error -select_streams v:0 -show_entries stream=width,height,nb_frames,avg_frame_rate,duration -of json $Out
这条命令的每个参数
每个参数都在本文步骤 8 的命令里出现过,作用如下:
--task i2v-1.3B:任务与模型规模,图生视频、1.3B。
--infer_mode causal_fast:少步蒸馏的因果推理路径,单卡可跑;causal_pretrain 是另一条更慢的路径。
--size 480\*832:输入面积与朝向;输出会按起始图的宽高比改写成 832×464。
--frame_num 13:生成帧数;这条路径最短的合法长度是 13(4n+1),小于它会把时间维收成 0。
--ckpt_dir / --assets_dir:DiT 权重目录,以及共享的 T5 / VAE / tokenizer 目录。
--image / --action_path:起始图,以及相机轨迹动作文件目录;causal_fast 缺 --action_path 会在采样前退出。
--t5_cpu:把 T5 文本编码器放在 CPU 上,省显存。
--convert_model_dtype:加载时把权重转成 bfloat16。
--offload_model True:每一步前向之后把模型挪回 CPU。
--local_attn_size 18 / --sink_size 6:KV cache 的窗口长度与固定保留的前缀帧数。
--base_seed 42:随机种子,便于复现。
实测结果与验收
本次在一台 6GB 显存的笔记本上跑通,输出规格与过去的记录一致:
- 生成段:日志里
Generating video到Saving generated video之间 763 秒(约 12 分 43 秒),含模型加载之后的全过程。 - 输出:832×464、13 帧、16 fps、0.8125 秒,文件 1,273,344 字节,SHA-256 为
897c908d04950630a89ac88f95e3831c3327f76e4be796af0d2b507cf6d66b8f。 - 显存:运行中采到一次读数 4996 MiB / 6144 MiB(空闲 44 MiB),没有 OOM。
- 权重:DiT 6838201925 字节,T5 与 VAE 等共享资源合计 18729186304 字节,13 项 SHA-256 全部匹配。
- 下载:同一个轮子,单连接约 2.15 MiB/s,aria2 多连接均速约 18 MiB/s、峰值 24 MiB/s。

常见问题、边界与许可
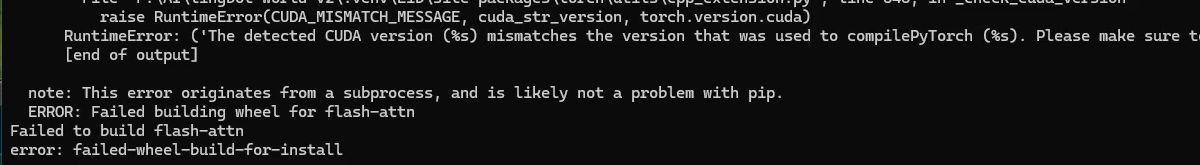
flash-attn 装不上?(这个分支已经绕过这一步) 上游代码里 causal_fast 的 cross-attention 硬依赖 flash-attn,而它在 Windows 上没有可用轮子,回退源码编译又要求 MSVC 和与 PyTorch 一致的 CUDA 版本 —— 照上游原样跑,会停在安装这一步(三条原因同时成立)。本分支的 wan/modules/attention.py 加了一条与 flash-attn varlen 语义等价的 PyTorch SDPA 实现:GQA 展开、变长 padding、causal、滑动窗口;装了真 flash-attn 的环境会自动优先用它,不需要回滚,也可以用 WAN_ATTENTION_IMPL=auto|flash|sdpa 强制切换。想核对改了什么,看 deploy/patch/attention-patch.diff(125 行)与 deploy/patch/VERIFY.txt(17 项离线测试 + CUDA 冒烟)。
显存那 4996 MiB 是峰值吗? 不是。那是运行中的一次采样读数,不是按固定间隔连续采样的峰值,所以不能拿它和别的方案比大小,只能说明这一次没有 OOM。
退出码为什么没写? 当时那条输出退出码的命令没有落盘,本次没有回读,所以本文不补一个数字。成功的证据是输出文件存在、ffprobe 通过、规格与记录一致。
这个结果能推广吗? 只对本文这台机器与这套版本负责。更高分辨率、更多帧、其他显卡、实时生成和商业使用都没有验证。
边界:上游代码与模型许可是署名、非商业、相同方式共享(CC BY-NC-SA 4.0),本教程不提供商业授权;本分支的 SDPA 补丁是本机实验改动,不是官方支持路径,遇到问题请同时对照上游 README。