6GB 显存也能跑世界模型,而且能出片
在 6 GB 显存的笔记本 GPU 上,1.3B 的世界模型能跑出成片。代价是时间:不到 1 秒的画面要生成十多分钟,镜头也还不太听话。
LingBot-World 2.0 · 1.3B
RTX 3060 Laptop · 单卡实测
1. 研究问题与主要结论
本研究考察的问题是:在显存容量为 6 GB 的笔记本 GPU 上,蚂蚁灵波 LingBot-World 2.0 的 1.3B 图像到视频模型能否生成一段可播放的视频;若可以,限制它的是显存、片段长度,还是速度。
在窗口 18+6、T5 放在 CPU、模型按配置以 bfloat16 加载的条件下,湖边短片、加长片、换轨迹、换场景和走回起点都写出了成片。五次显存峰值都在 5963–5983 MiB,扣掉空闲基线后是 5934–5983 MiB。这个跨度里看不出与片段长度的关系:帧数最少的换轨迹一次反而最高。这些运行都不是实时。
| run_id | 运行时长 | 显存峰值 |
|---|---|---|
LB2-HEAD-001 |
728 s | 5978 MiB |
LB2-LEN-001 |
1496 s | 5975 MiB |
LB2-CAM-001 |
808 s | 5983 MiB |
LB2-SCENE-001 |
808 s | 5963 MiB |
LB2-BACK-001 |
1500 s | 5975 MiB |
上表的运行时长是 metrics/<RunId>.json 的 wall_clock_s:从 xterm 启动到命令结束再加 4 秒,含模型加载、采样,以及逐字敲入命令的约 20 秒;不含录屏收尾。显存峰值含空闲基线,而基线并不相同:LB2-HEAD-001 为 44 MiB,其余四次为 0。跨 run 直接比峰值并不牢靠,上面用的是扣掉基线后的净占用。做法见第 6 节。
官方 README 的参考命令是 480×832、多进程。本机只有一张卡。
generate.py在单进程下不允许 FSDP,也不允许ulysses_size大于 1。 这里测的是单进程路径,不是那条多卡命令,也不是未发布的 720p / 60 fps 部署栈。
2. 测试环境
| 项目 | 配置 |
|---|---|
| GPU | RTX 3060 Laptop GPU,6144 MiB,compute capability 8.6 |
| 系统内存 | WSL2 可见约 47 GiB;宿主机为 64 GB DDR5 |
| 操作系统 | Windows 11,推理运行于 WSL2 Ubuntu 24.04.5 |
| 代码 | lingbot-world-v2,commit 1895d300 |
| PyTorch | 2.11.0+cu128 |
| CUDA | 12.8.93 |
| flash-attn | 2.8.3.post1,对应 cu128 与 torch 2.11 |
被测权重是 lingbot-world-v2-1.3b-causal-fast 的 DiT。Hugging Face 的模型记录记为 float32,
17.1 亿个参数,六个分片合计 6525 MiB。T5、VAE 和分词器来自 14B 包,没有下载 14B 的 DiT。逐文件 SHA256 在该实验的 model.json。索引文件的 SHA256 为 b0409d66…022e42。
许可证为 CC BY-NC-SA 4.0。本报告只记录这次测量,不构成商业使用授权。
RTX 3060 的移动版显存为 6 GB。桌面版不是这一张卡,两组数字不能互相引用。 采集画面来自 Xvfb 虚拟显示,不是 Windows 桌面录屏。
3. 实际执行的命令
成功运行共用下面的参数。帧数、起始图、轨迹和提示按各节更换。命令留档在 01-实验/2026-09-26_lingbot-world-1.3b-6gb/_runners/。
python generate.py --task i2v-1.3B --infer_mode causal_fast \
  --size 480*832 --frame_num 13 \
  --local_attn_size 18 --sink_size 6 \
  --t5_cpu --offload_model True --convert_model_dtype \
  --image examples/03/image.jpg \
  --action_path examples/03 --base_seed 42
--size 480*832 是面积参数。代码按起始图的宽高比改写输出。
ffprobe 读到的成片是 832×464,不是 480×832 像素。帧率 16 fps,来自模型配置里的 sample_fps,并由 ffprobe 的 avg_frame_rate=16/1 核对。
causal_fast在进入采样前断言必须提供action_path。 第一次尝试没有这一参数,进程在生成开始前退出。成功的两次使用仓库自带的examples/03,其中含poses.npy与intrinsics.npy。
4. 13 帧:最短可运行长度
请求 5 帧时,chunk_size 为 4,时间维 latent 被收成 0,随后申请形状
[1, -3, 58, 104]。按同一公式,最短可运行的 4n+1 是 13。
| 项 | 观测 |
|---|---|
| 成片 | 832×464,13 帧,0.8125 s,1 271 538 字节 |
| 生成段 | 日志 18:31:58 至 18:42:19 |
| 显存 loaded / peak | 5959 / 5978 MiB |
| 匿名内存峰值 | 25537 MiB |
| swap | 未触发 |
生成段的秒数由上述两行日志相减,未自动核验。墙钟 728 s 含加载与录屏收尾,已列入第 1 节的表。
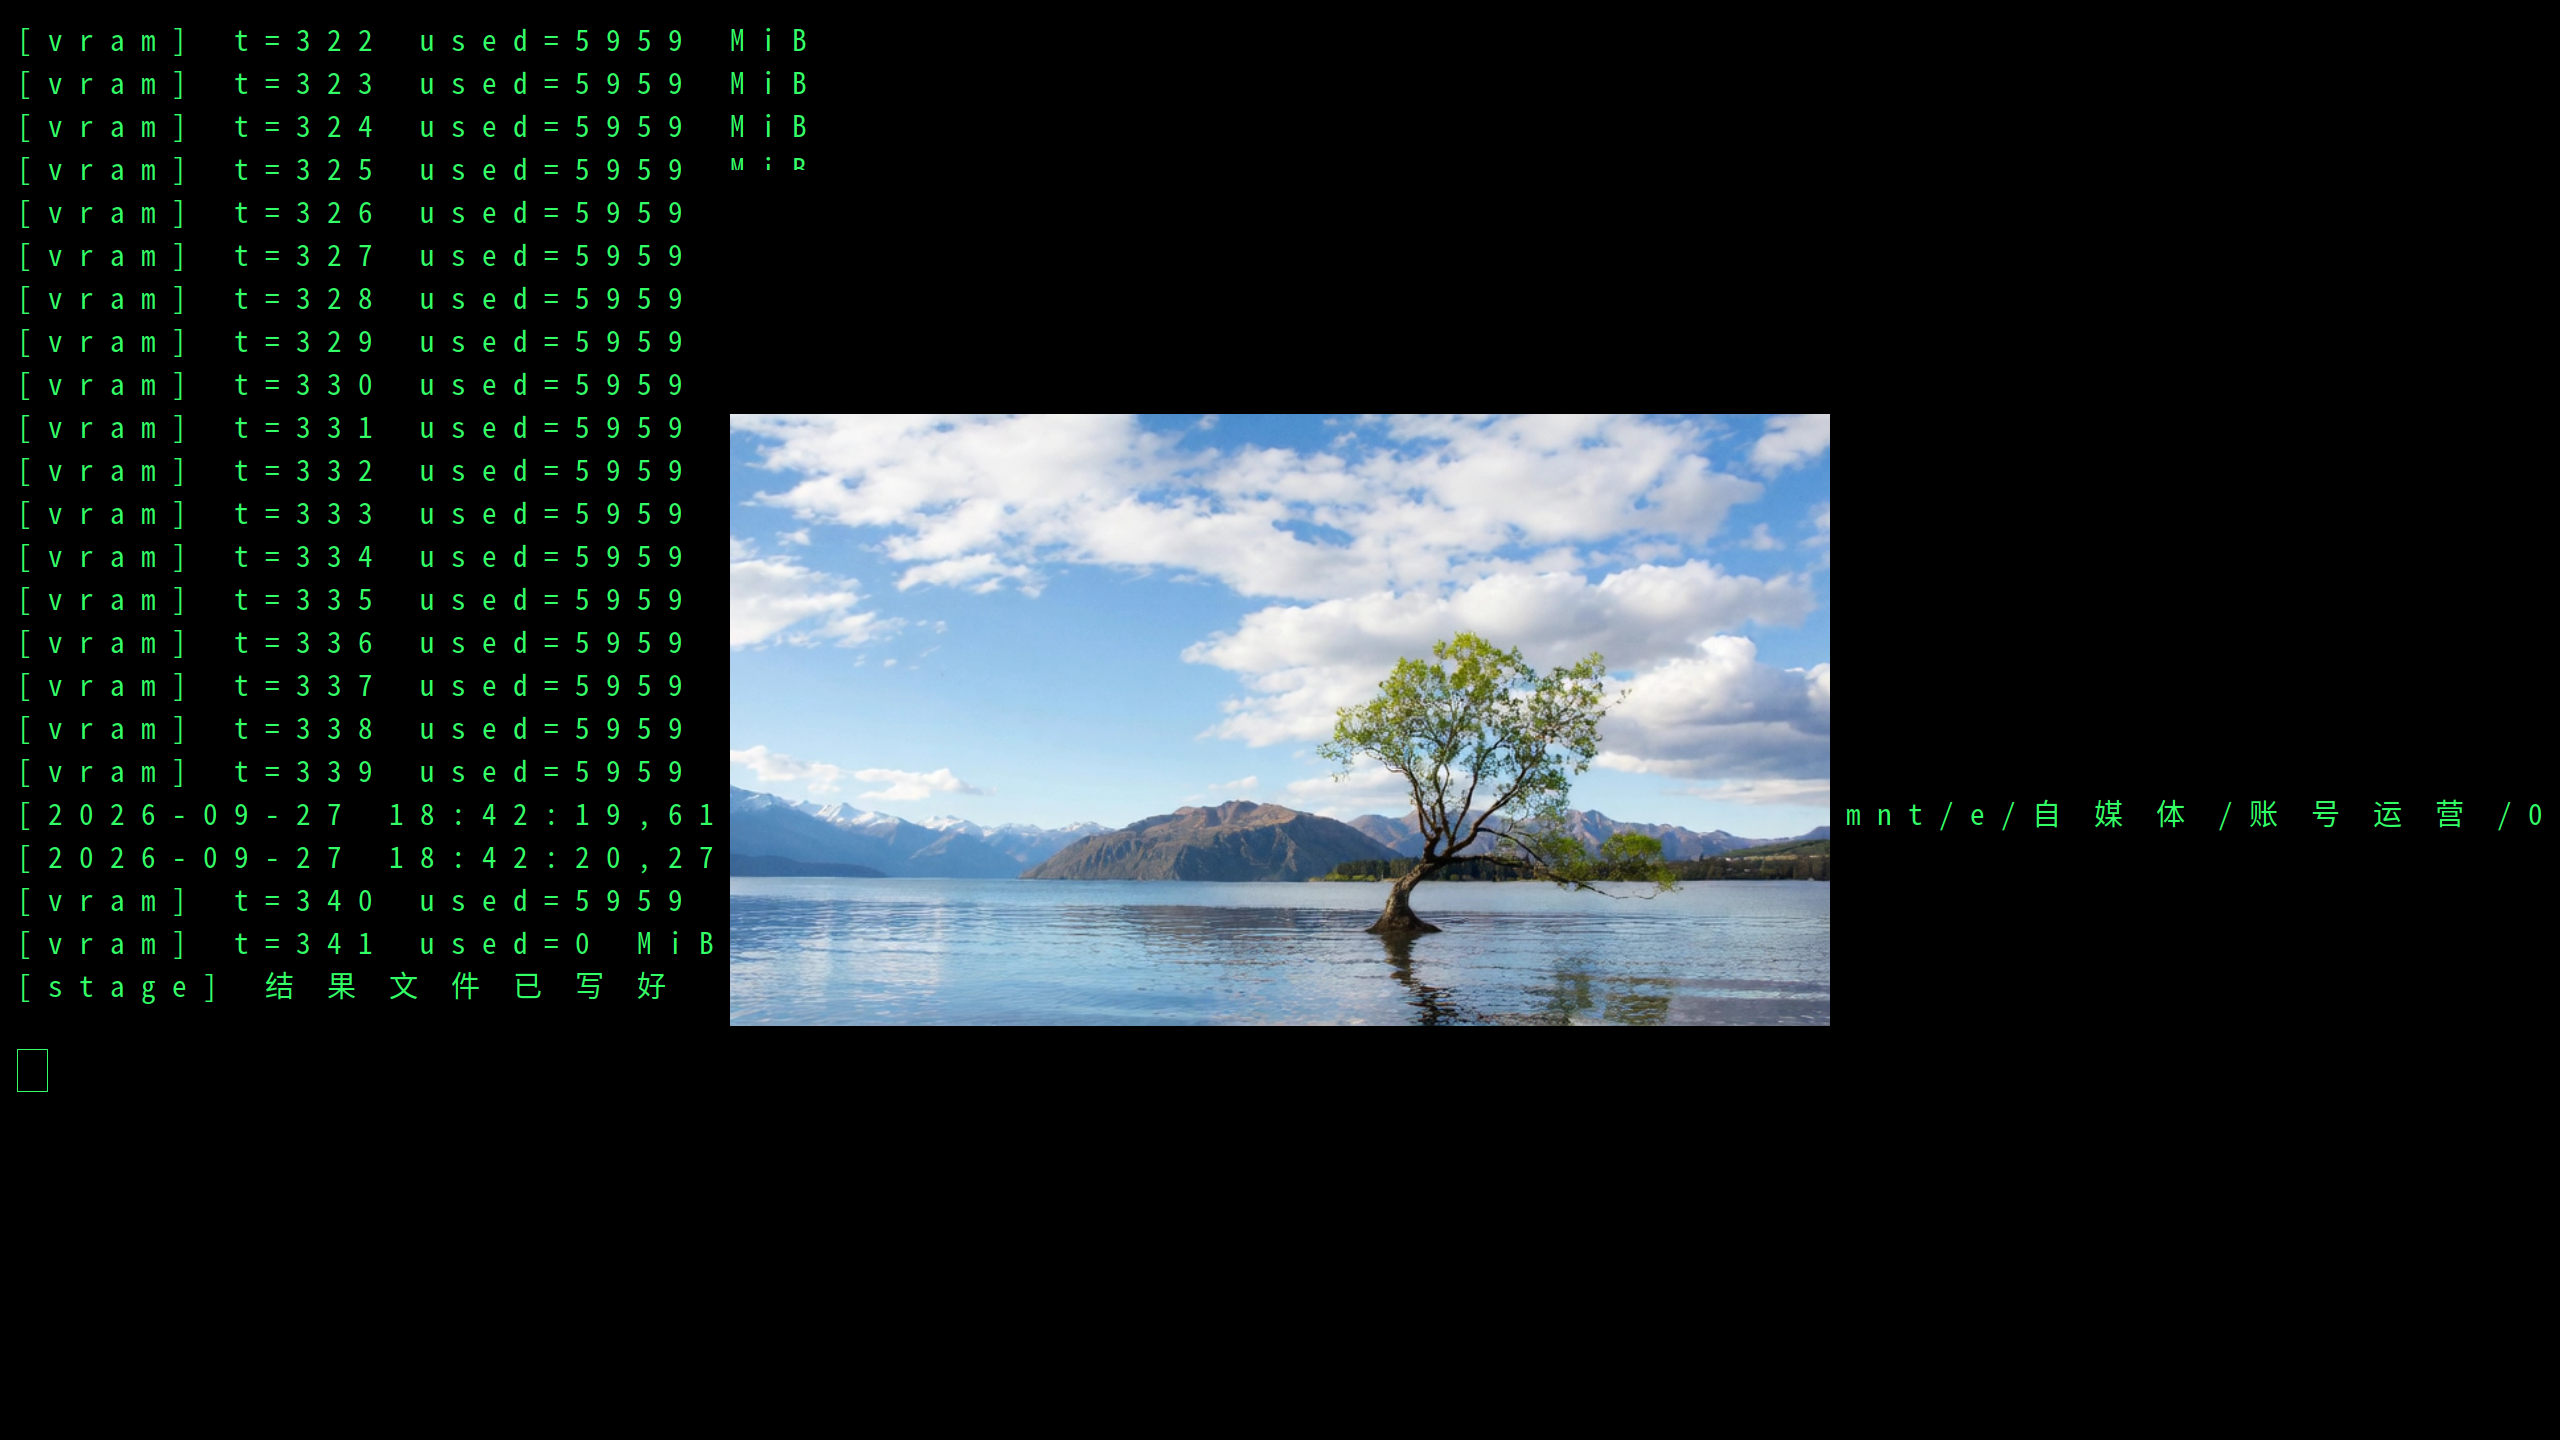
5. 29 帧:加长以后变的是时间
21 帧会被同一条 chunk_size 4 规则收回到 13,测不出更长的片段。下一档真正变长的 4n+1 是 29,即 LB2-LEN-001。
| 项 | 观测 |
|---|---|
| 成片 | 832×464,29 帧,1.8125 s,2 580 550 字节 |
| 生成段 | 日志 18:44:30 至 19:07:22 |
| 显存 loaded / peak | 5945 / 5975 MiB |
| 匿名内存峰值 | 25111 MiB |
| swap | 未触发 |
生成段约 1372 s(13 帧约 621 s),未自动核验。净占用 5975 MiB,仍在 13 帧的区间内。
6. 换轨迹、换场景、再走回来
LB2-HEAD-001 是湖边图配 examples/03 的前 13 帧,没有重跑。下面三条只改图或轨迹。窗口、种子和单卡不变。墙钟与显存峰值在第 1 节。
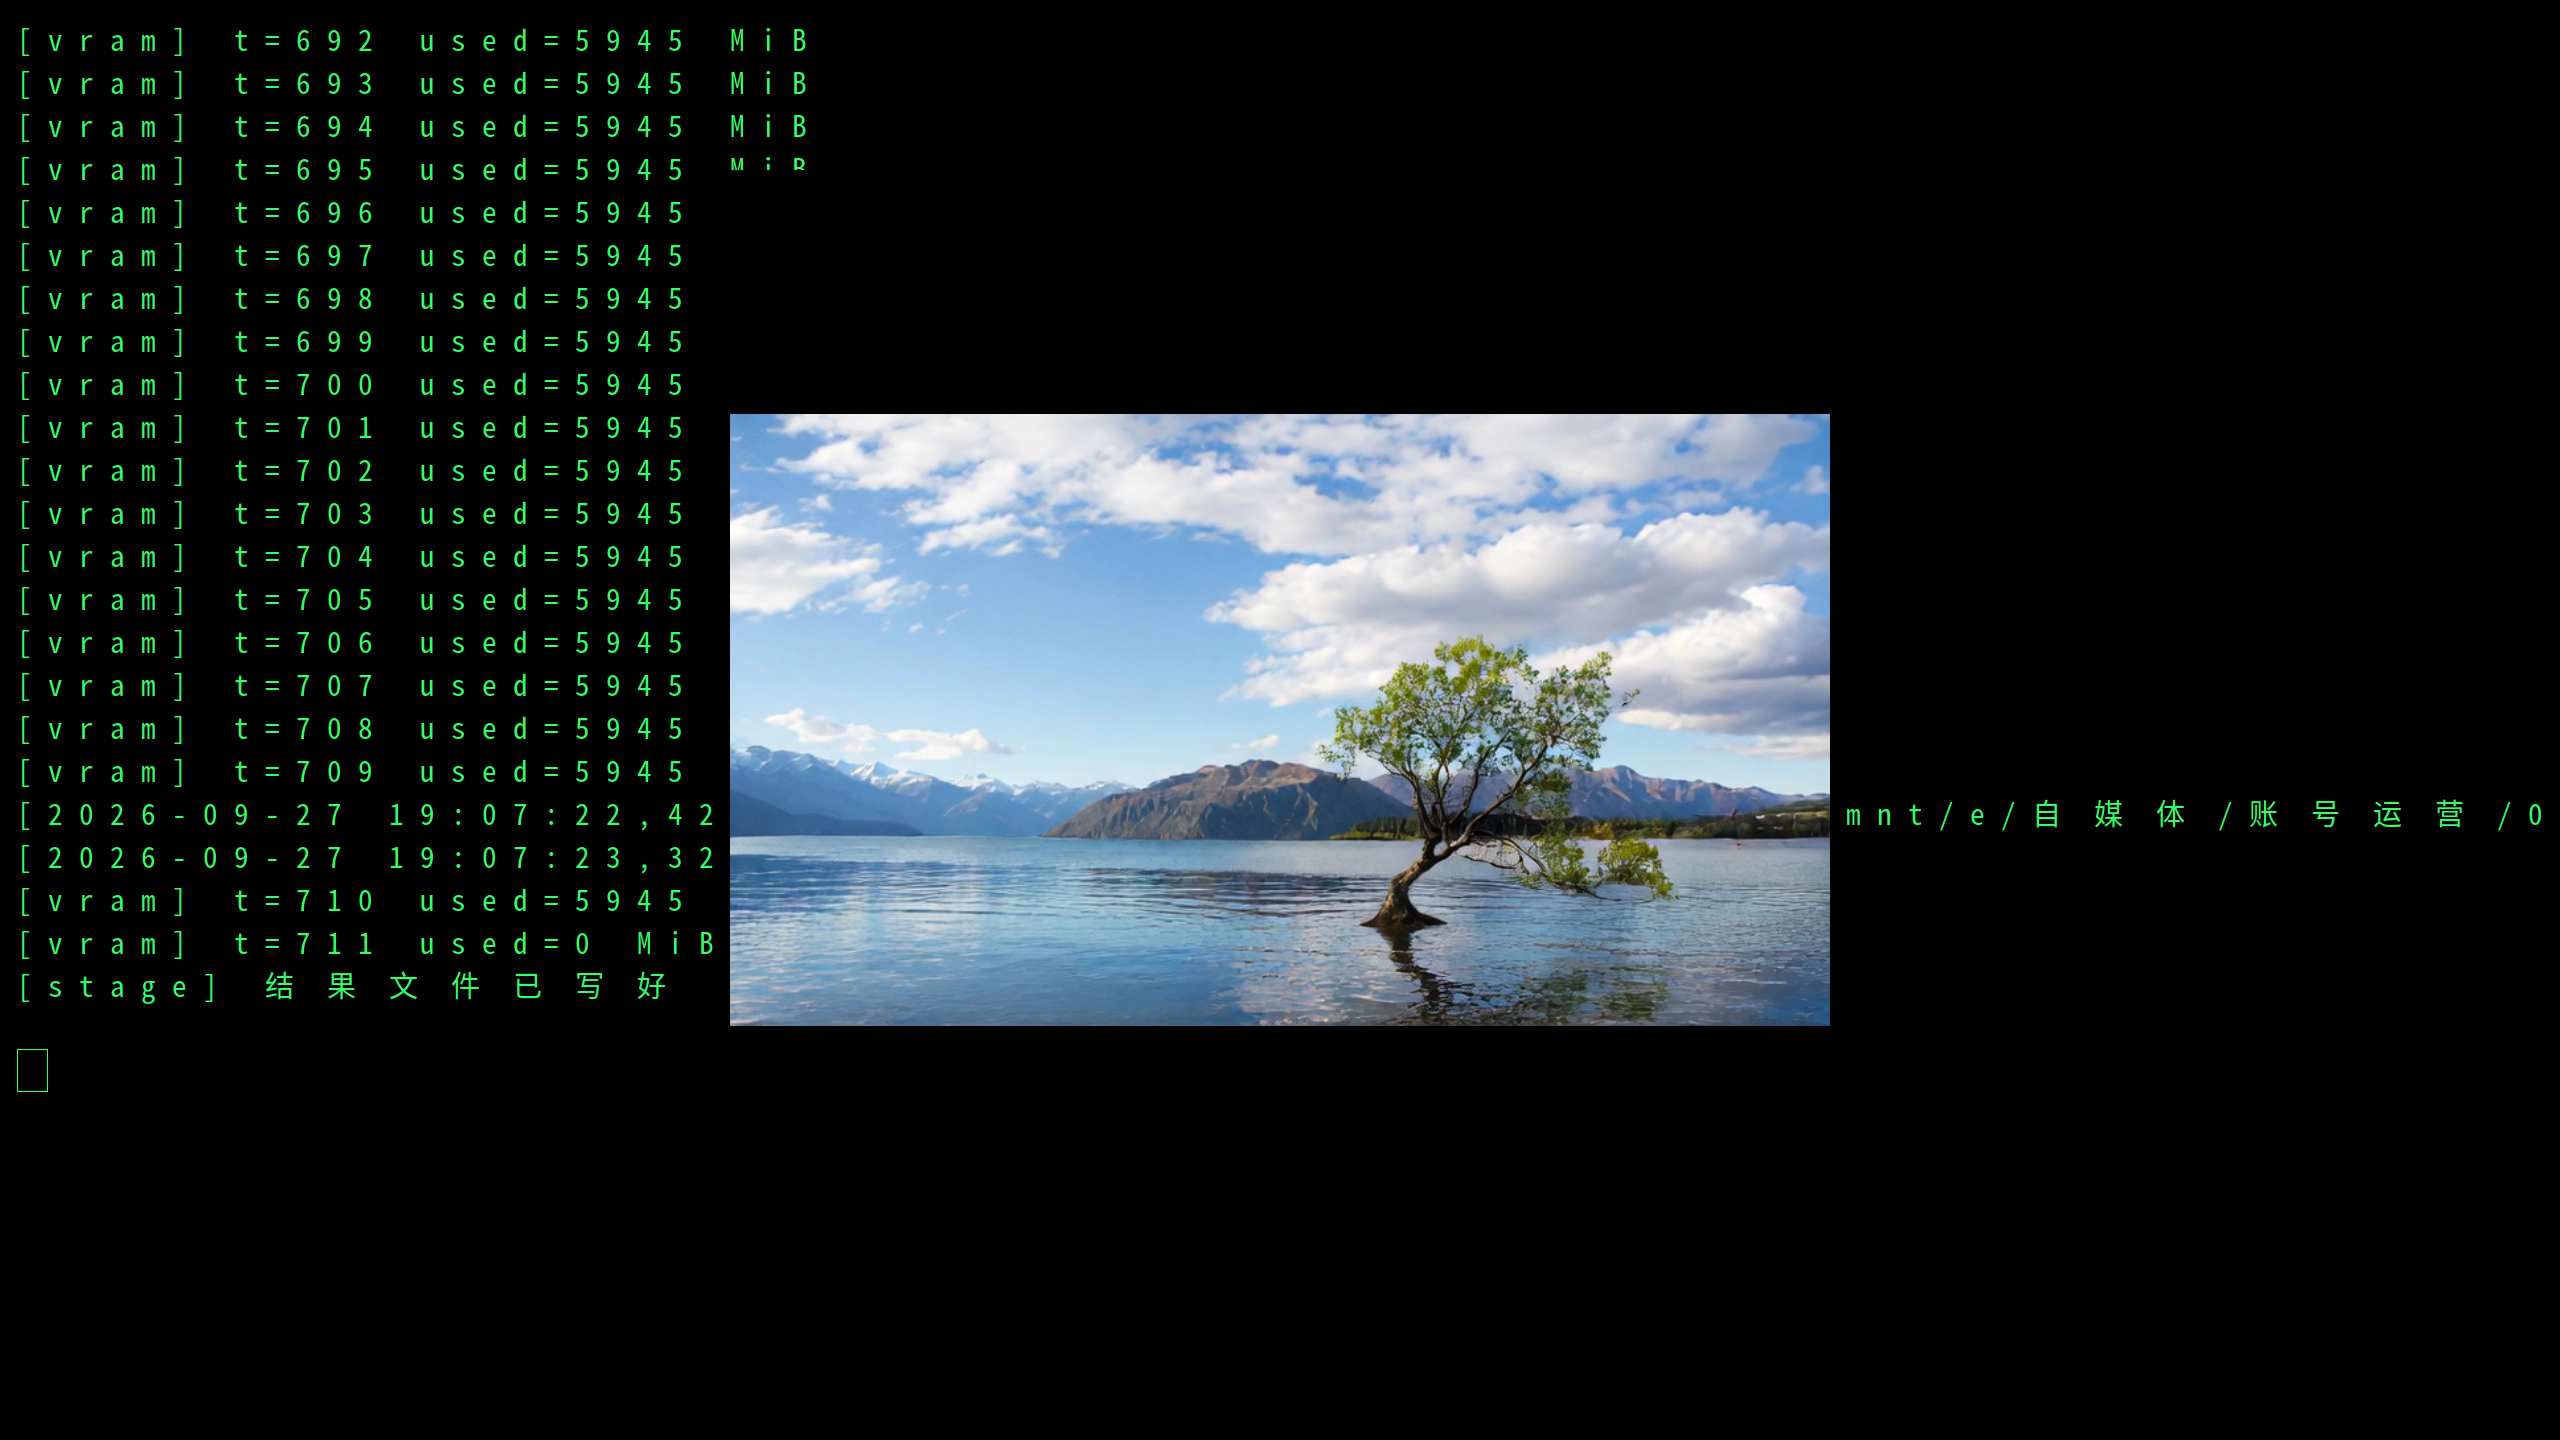
同一张湖边图换成第 208–220 帧的侧向位姿,即 LB2-CAM-001。首末帧平均像素差 52.95,原来那条是 38.95。树仍在画面右侧的湖里。像素差由该实验归档的 results/pixdiff.cjs 从成片复算,但它不是方向精度,也不能当成镜头已经按侧向幅度走完。
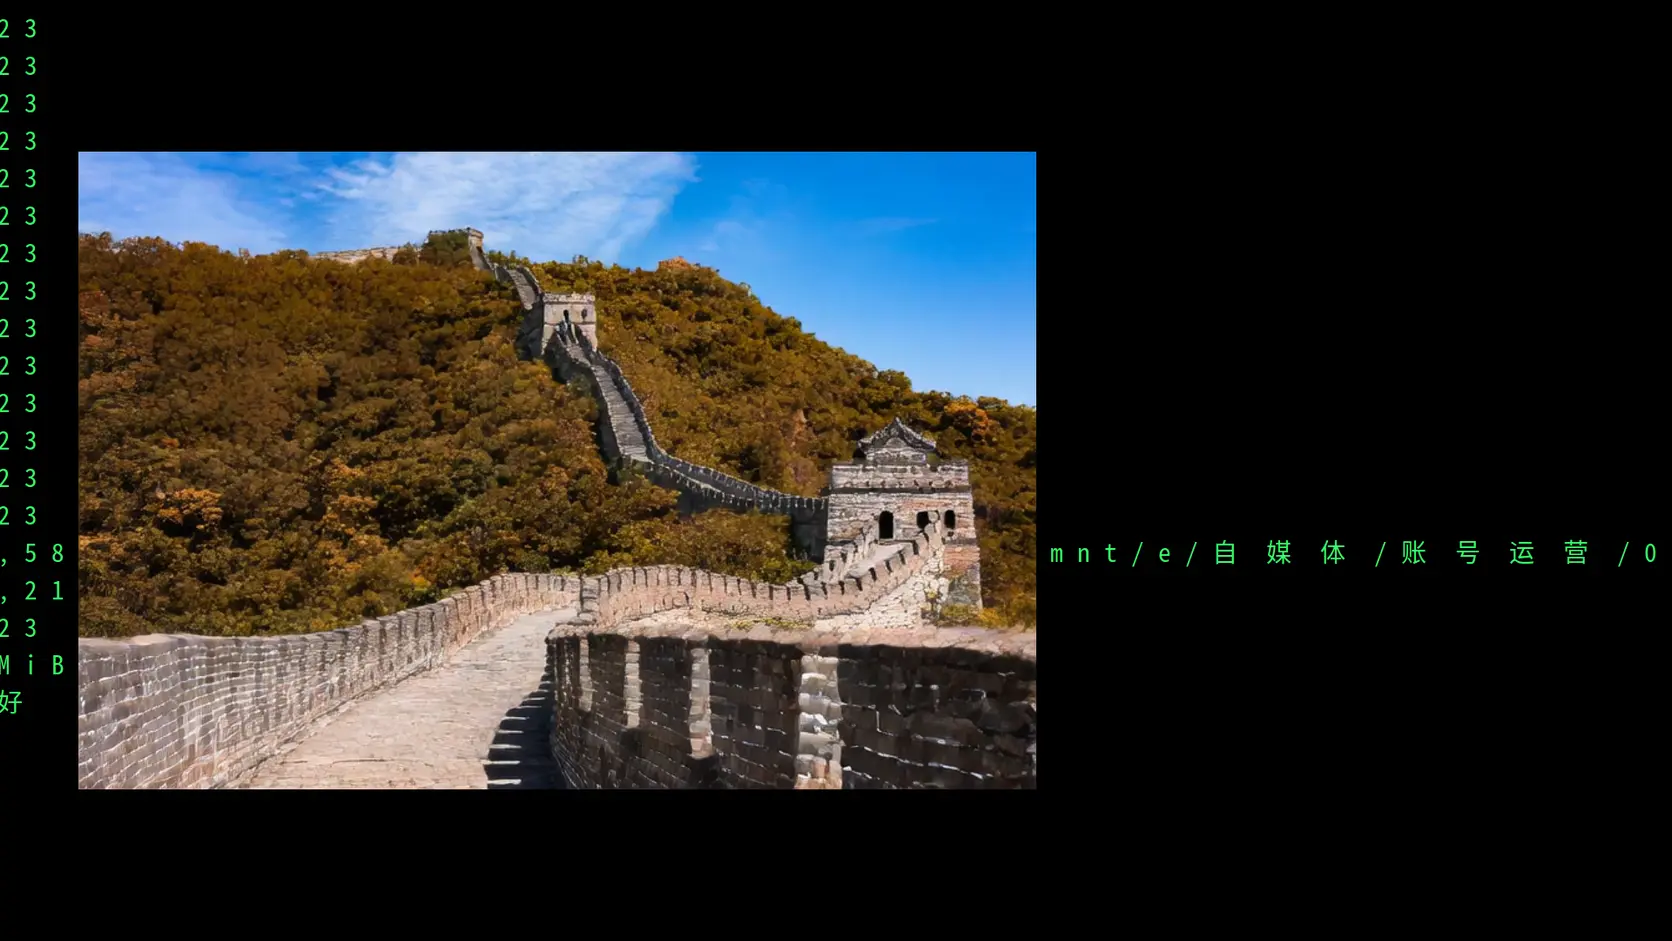
换成长城图和它自己的前 13 帧,提示写成秋日长城,即 LB2-SCENE-001。首帧和末帧都是长城与烽火台,不是湖。成片为 768×512,因为代码按这张图的比例改尺寸。
同一张湖边图走出再按原位姿倒回起点,即 LB2-BACK-001,29 帧。首帧、第 15 帧和末帧里,树都还在。首帧到第 15 帧的像素差是 38.72,首帧到末帧是 32.58。末帧更接近开头,但不是同一张画面。
7. 结论
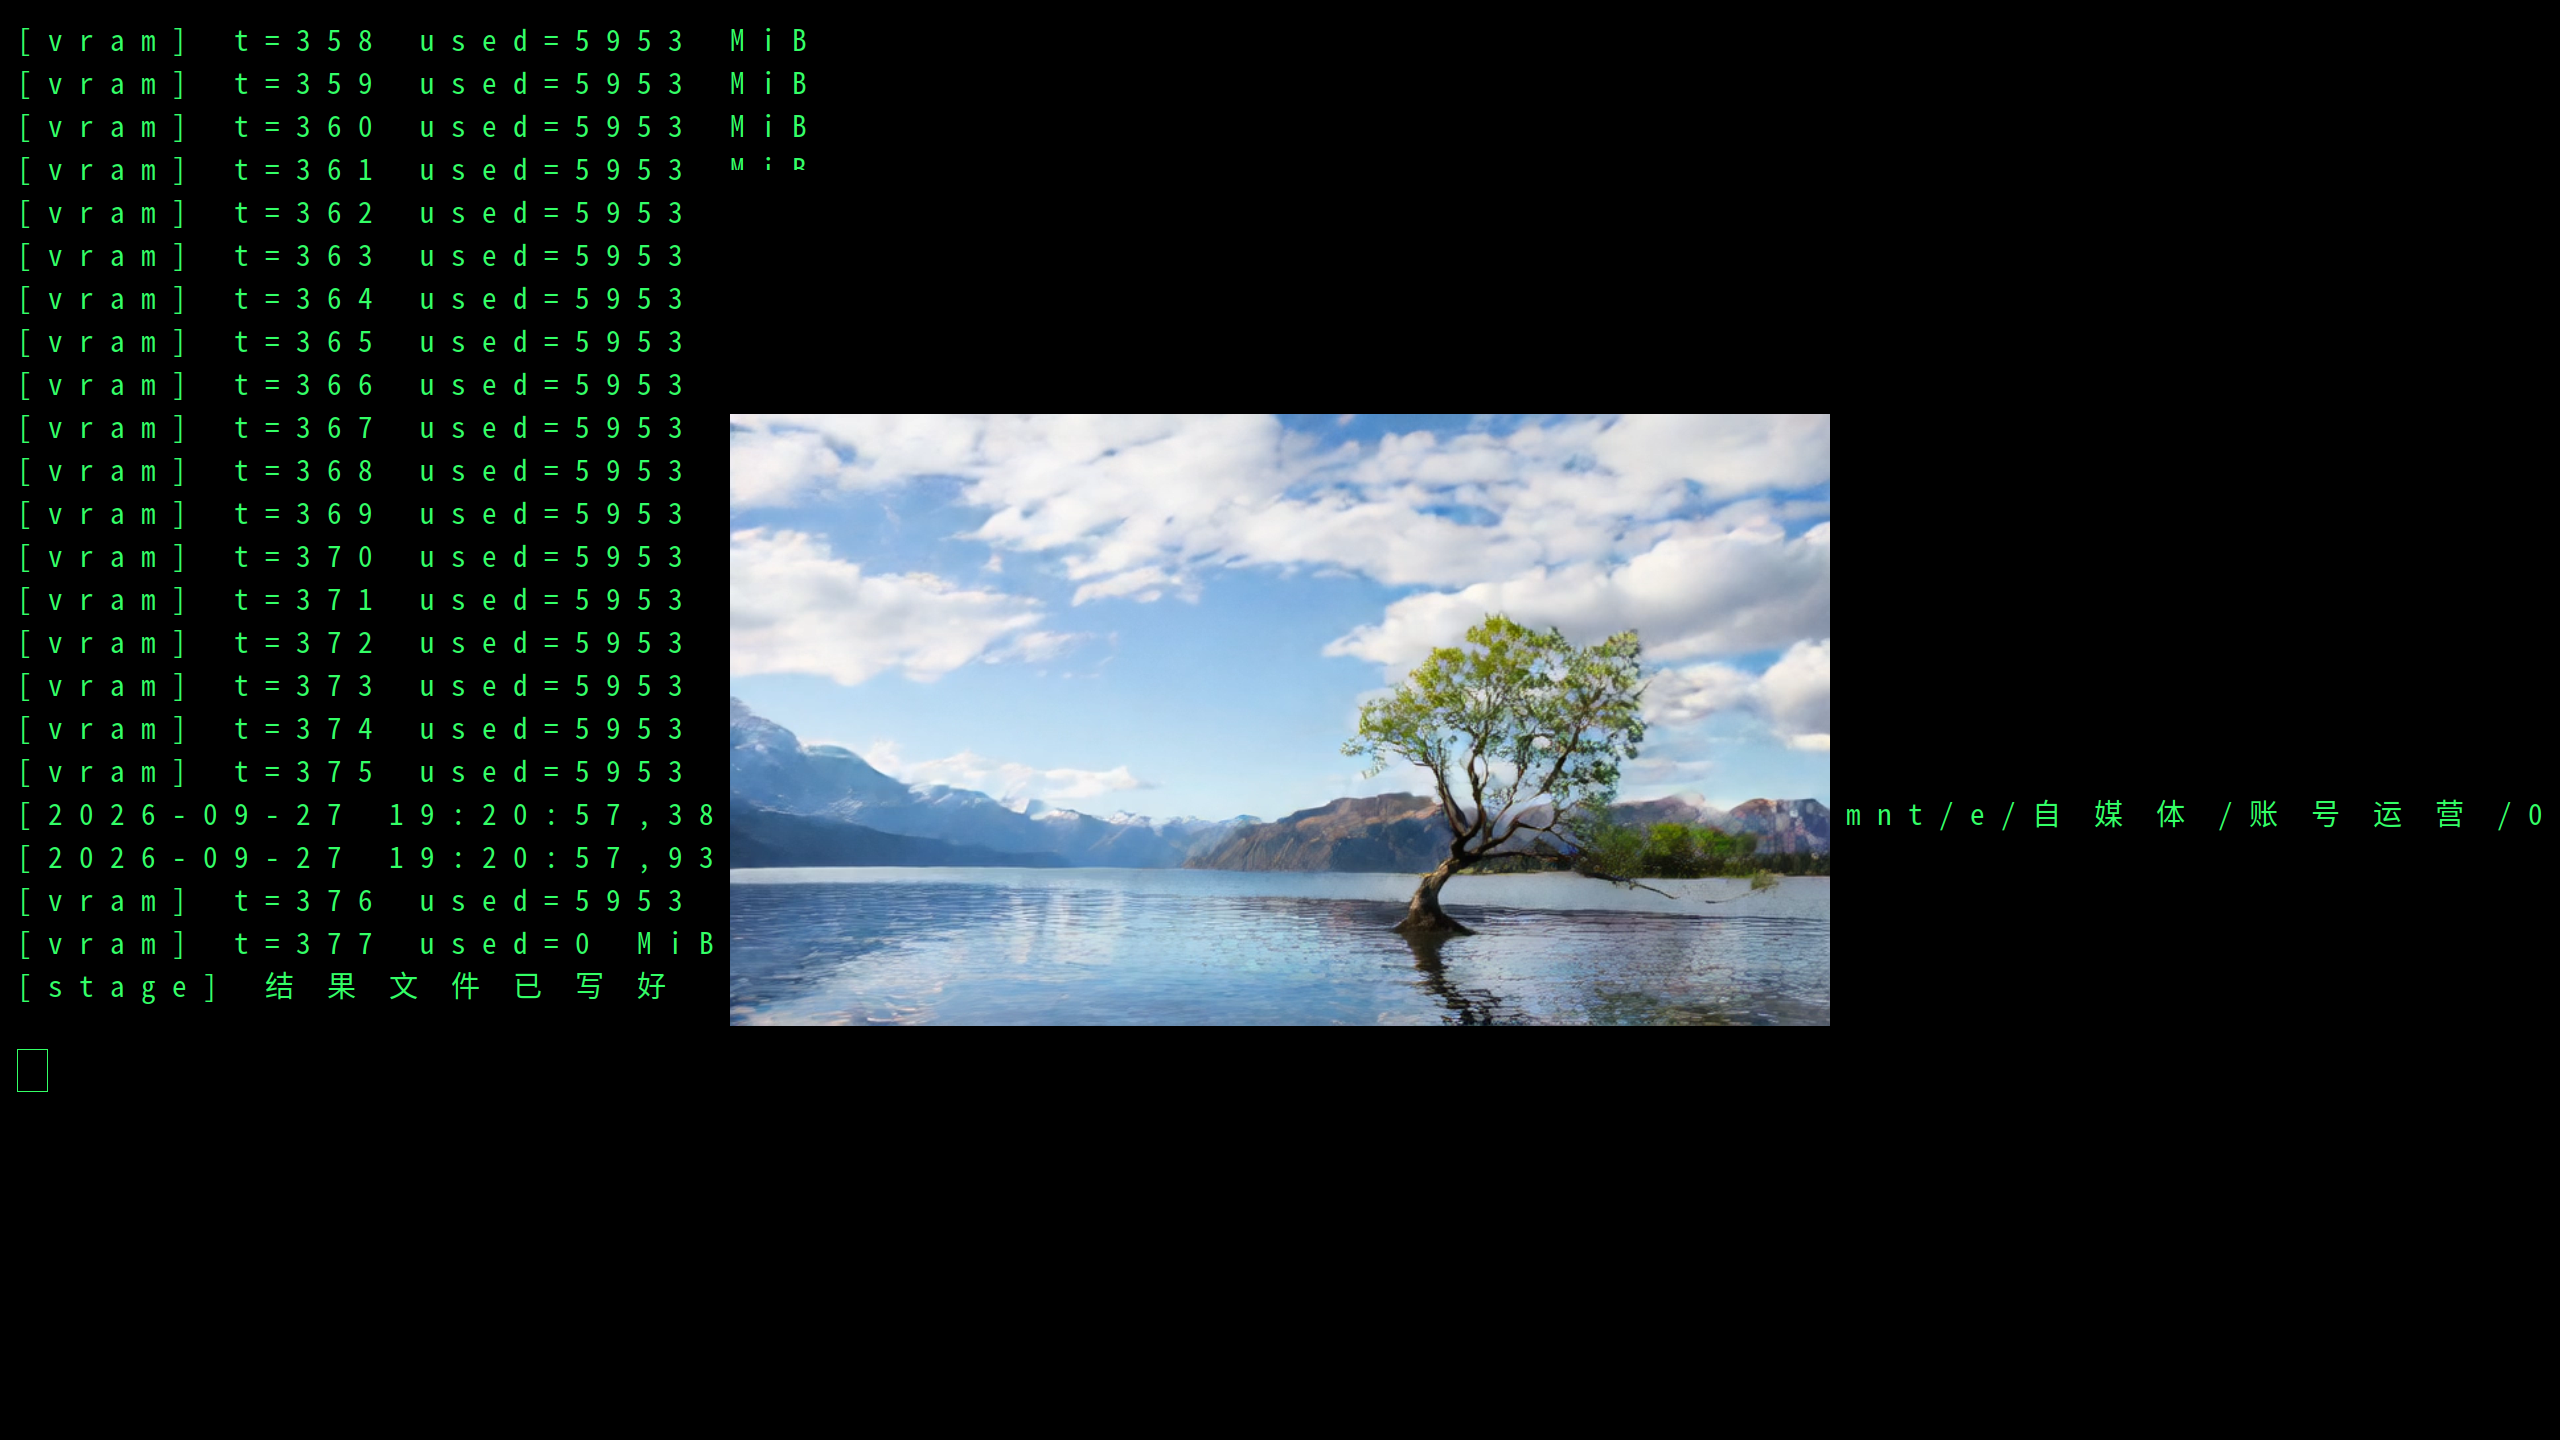
6GB 的笔记本显卡能把这个世界模型跑出视频。五次都出了片,显存占用都落在 5934–5983 MiB 这一档,把片段加长也推不动它。
代价是时间。不到 1 秒的画面,要生成十多分钟。它不是实时。
画面能换地方。给一张长城图,出来的是长城和烽火台,不是湖;树也一直待在原位。镜头还不太听话:换成侧向轨迹,画面确实动得更多,但没有走完;原路走回去,最后一帧也没有回到开头那一帧。
想自己试的话,一张 6GB 卡就够跑起来,只是别按实时视频去期待—— 这是笔记本上的 1.3B,不是官方那套 720p / 60fps 的部署栈。