编程智能体开口前要先读多少字?pi 1.4k、Codex 6.4k、Claude Code 15.8k tokens
从 llama-server 日志里读出三个智能体第一次请求的提示词长度和处理耗时。在 6GB 笔记本上,光读提示词,Claude Code 就比 pi 慢 8.6 倍。
数字
接同一个 llama-server(LFM2.5-24B-A2B Q4_0,-c 32768,RTX 3060 Laptop 6GB),每个智能体第一次请求时,日志里的 prompt eval:
| 智能体 | 提示词 tokens | 处理耗时 | 占 32K 上下文 |
|---|---|---|---|
| pi | 1,442 | 5.7 s | 4% |
| pi(精简后) | 775 | — | 2% |
| Codex | 6,429 | 18.6 s | 20% |
| Claude Code | 约 15,800 | 48.8 s | 48% |
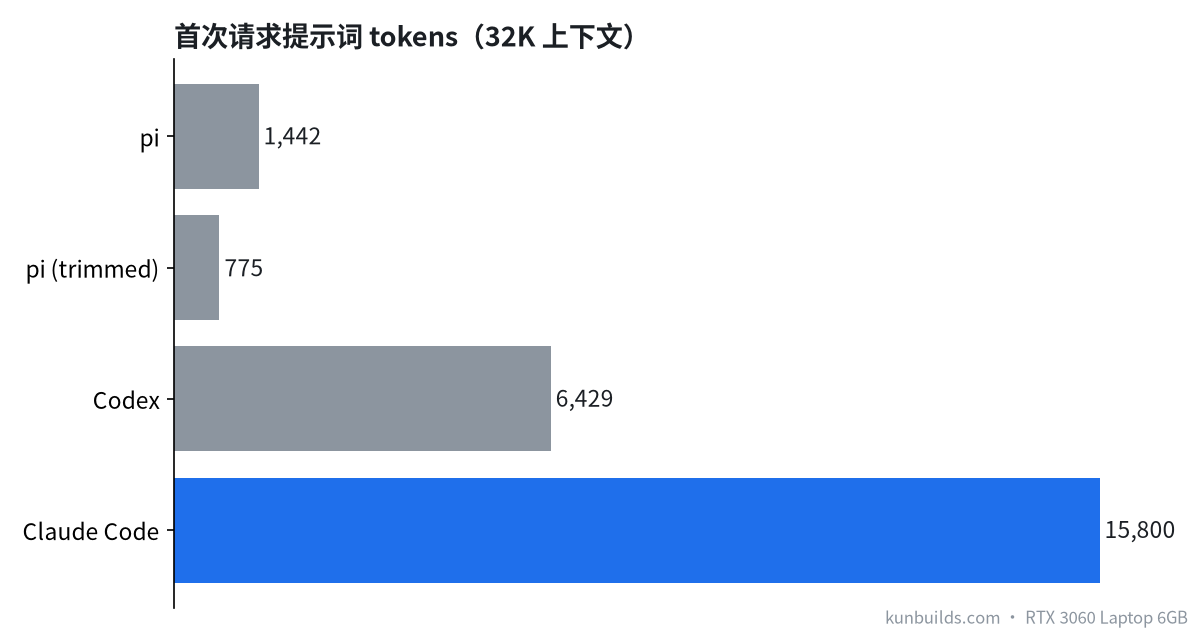
这些 token 是用户提问之前就发出去的:系统提示词、工具说明和环境信息。
为什么本地模型更在意
云端模型上下文动辄几十万 token,读一万多 token 也就几秒。本地小卡不一样:
- 时间:6GB 笔记本预填大约每秒两三百 token。每次新会话都先等几十秒。
- 空间:32K 上下文被占一半,剩下的要装代码、工具输出和多轮对话。我们实测里 Claude Code 两次因
Prompt is too long失败,压缩也失败。
能不能砍
pi 的系统提示词可以自己改。我们把它精简到七百多 token,只开 read/edit/bash 三个工具,12 项任务照样全过,速度和原版差不多。
读数口径
取的是每组第一次运行的第一条 prompt eval。llama.cpp 会缓存相同前缀,同一个智能体后面几次的数字只算新增部分,会偏小(比如 Codex 后面显示 394、516)。