同一个本地模型,pi 12/12、Claude Code 7/12:6GB 显卡实测三个编程智能体
LFM2.5-24B 和 Qwen3.6-35B 跑在 6GB 笔记本的 llama.cpp 上,分别接 pi、Codex、Claude Code 做三道题。pi 全过且最快;Codex 全过但工具参数错了 12 次;Claude Code 系统提示词吃掉半个上下文,还出现“说做完了、目录是空的”。
视频
结论
| 智能体 | 通过 | LFM 修 bug 中位耗时 | 首次请求提示词 |
|---|---|---|---|
| pi | 12/12 | 47 s | 约 1,400 tokens |
| Codex | 12/12 | 85 s | 约 6,400 tokens |
| Claude Code | 7/12 | 132 s | 约 15,800 tokens |
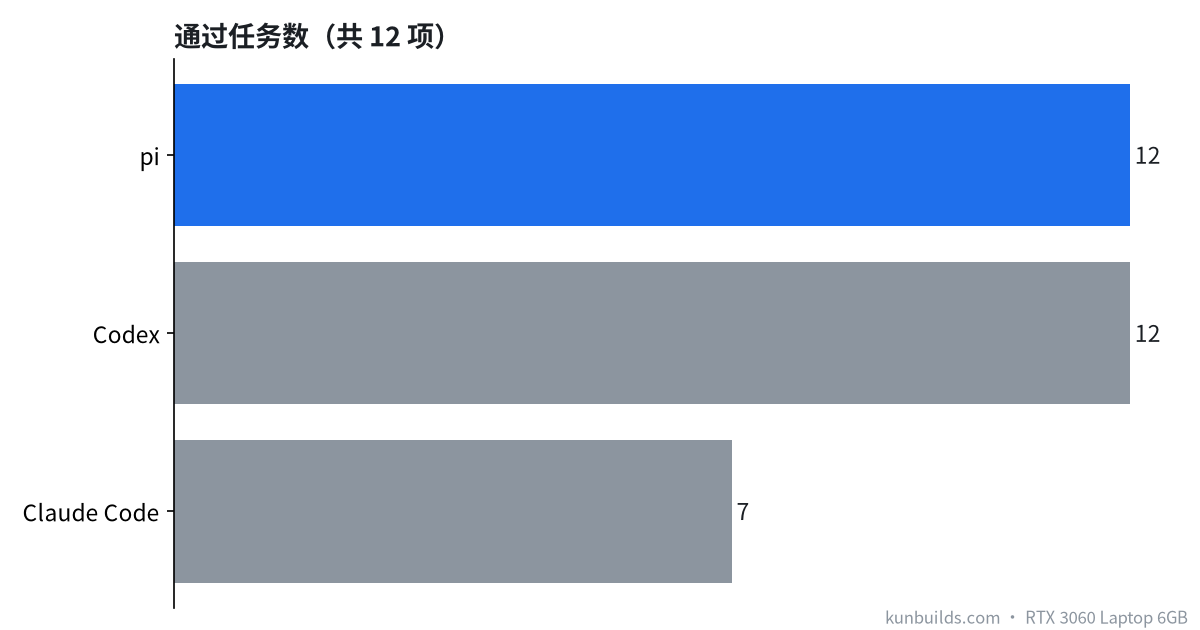
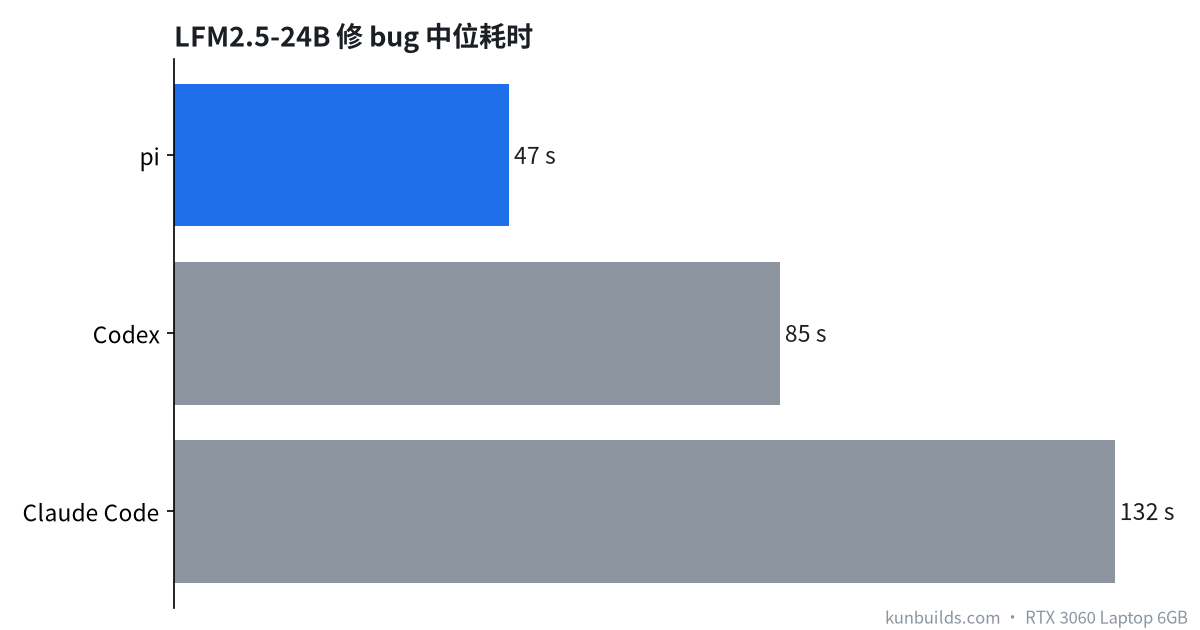
模型没换,换智能体,结果从全过变成过一半多一点。小上下文的本地模型上,智能体自己的提示词有多大,基本决定了它能不能用。
怎么测的
- 机器:RTX 3060 Laptop 6GB + 64GB 内存,WSL2 Ubuntu 24.04。
- 推理:llama.cpp
9655061,llama-server -c 32768 -ngl 99 -fa on -ctk q8_0 -ctv q8_0 --jinja;LFM-ncmoe 36,Qwen-ncmoe 40。全程离线。 - 模型:LFM2.5-24B-A2B Q4_0(每项 3 轮);Qwen3.6-35B-A3B UD-Q4_K_XL(每项 1 轮,对照)。
- 三道题:
- A:修
calc.py两处 bug,让 pytest 全绿; - B:写一个单文件计时器网页,用脚本按 8 项清单检查;
- 鹈鹕:
Generate an SVG of a pelican riding a bicycle。
- A:修
- 每次运行上限 900 秒。
提示词:问题的根源
每次对话,智能体都先把自己的系统提示词和工具定义发给模型。llama-server 日志里第一次 prompt eval:
| 智能体 | tokens | 耗时 |
|---|---|---|
| pi | 1,442 | 5,666 ms |
| Codex | 6,429 | 18,567 ms |
| Claude Code | 约 15,800 | 48,837 ms |
32K 上下文,Claude Code 开口前就占了一半。读一遍提示词,它比 pi 慢约 8.6 倍。
pi:最省事
两个模型 12/12,日志里工具调用错误 0。我把系统提示词精简到七百多 token、只开 read/edit/bash,结果同样全过,速度和原版基本一样。题目再难些也许会拉开差距,这次没有。
Codex:磕磕绊绊,但能自救
12/12 全过。LFM 上工具参数报错 12 次,典型是把整数当字符串传:
failed to parse function arguments: invalid type: string "96787", expected i32它会自己重试改对,代价是慢:修 bug 中位 85 秒,第一次跑了 599 秒。
Claude Code:最坑的不是报错
- LFM 修 bug 3 次只过 1 次,另外两次直接报:
Prompt is too long · automatic compaction failed: summarization produced empty response- 网页题倒是 3/3,但中位要 881 秒,有一次撞上 900 秒上限。
- 换成 Qwen,三项全挂。网页和鹈鹕两题,它都回复任务已完成,可工作目录里根本没有文件。
报错还能发现,“假装完成”只有自己去看目录才知道。
鹈鹕
Qwen 画得更完整。LFM 直接调用时,鸟像飘在车上;放进智能体里画,反而更像骑在车上。Claude Code + Qwen 没有产出 SVG。
局限
- 显存是每秒采样一次,几乎只看到常驻值(LFM 约 2,641 MiB,Qwen 约 3,111 MiB),能说明都没超 6GB,但抓不到推理时的瞬时峰值。
- 工具错误数是按日志关键字统计的近似值。
- Qwen 只跑了 1 轮。