llama.cpp 跑 MoE,把专家层全扔给 CPU 反而快 4 倍:-ncmoe 调参实测
6GB 笔记本上,Qwen3.6-35B-A3B 的专家层全放 GPU 时生成 5.2 t/s,全放内存时 21.5 t/s,显存还少一半。但这不是定律:LFM2.5-24B 的最优点在中间。
视频
一句话
-ngl 99 把所有层放进 GPU,-ncmoe N(全称 --n-cpu-moe)再把前 N 层的专家权重放回 CPU 内存。显存小、内存大的机器,先试“全部专家进内存”,再往回调。
35B:越往 CPU 放越快
Qwen3.6-35B-A3B UD-Q4_K_XL,RTX 3060 Laptop 6GB + 64GB DDR5,llama.cpp 9655061,llama-bench -ngl 99 -p 512 -n 128 -r 5:
| -ncmoe | 预填 pp512 (t/s) | 生成 tg128 (t/s) | 显存峰值 |
|---|---|---|---|
| 0 | 79.46 | 5.16 | 5940 MiB |
| 10 | 81.33 | 6.66 | 5962 MiB |
| 20 | 75.38 | 9.32 | 5972 MiB |
| 30 | 94.79 | 16.27 | 5978 MiB |
| 40 | 302.83 | 21.49 | 2860 MiB |
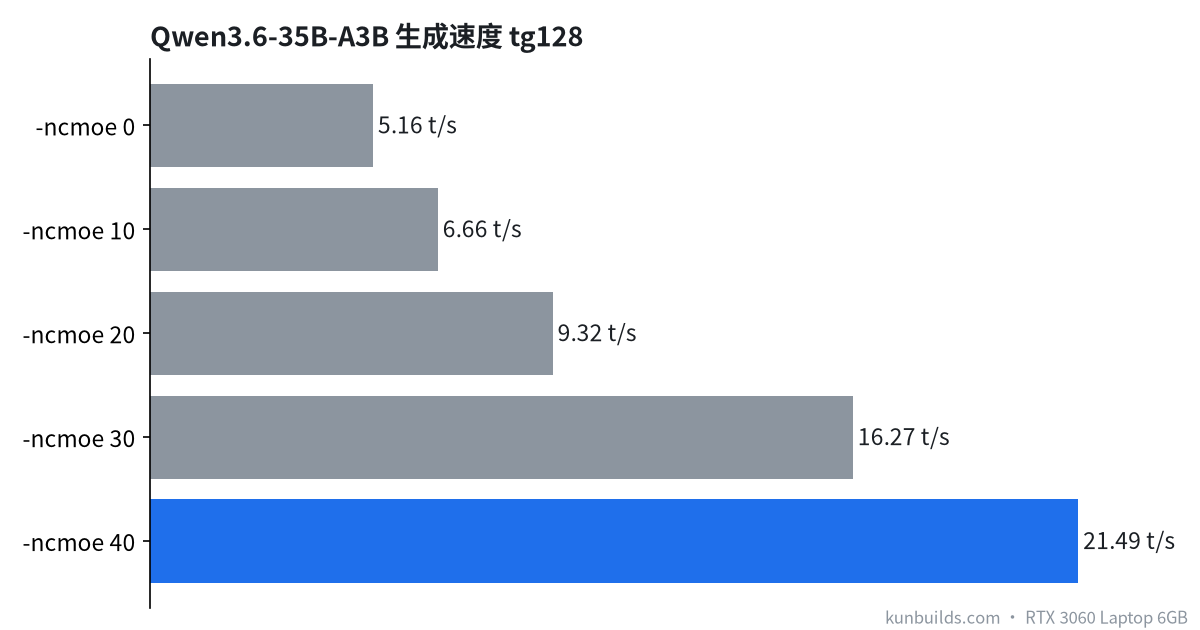
专家层留在 GPU 时,20 多 GB 权重挤不进 6GB,大量访问只能走 PCIe,每个 token 都在等。全部放回内存,GPU 只算注意力、路由和 KV cache,反而干净。
-ngl 也一样别留半截:固定 -ncmoe 40 时,-ngl 10 生成 8.50 t/s,-ngl 0 是 8.85,-ngl 99 是 22.92。
24B:最优点在中间
LFM2.5-24B-A2B Q4_0,同一台机器:
| -ncmoe | pp512 | tg128 | 显存(真题运行峰值) |
|---|---|---|---|
| 40 | 139.88 | 22.49 | 1299 MiB |
| 30 | 180.70 | 29.47 | 4535 MiB |
| 20 | 85.95 | 29.49 | — |
模型小了,显存装得下一部分专家,30 比 40 更快;再往下到 20,预填就掉到一半多。所以没有通用答案:从“全部进内存”开始,每次减 10,看显存和速度,找到拐点再细调。
KV cache 量化
16K 上下文下,KV 从 f16 改 q8_0 省 492 MiB,改 q4_0 省 574 MiB,速度差异在噪声里。专家层已经在内存里时,这点显存没换来速度;只有你打算把更多专家放回 GPU,它才有用。
内存
35B 这套配置,系统内存峰值约 23.8 GiB(大部分是页缓存)。这是专家层进内存的代价,64GB 机器没压力,16GB 机器就别想了。
相关
常见问题
-ncmoe 设多少合适? 从把全部专家层放 CPU 开始,每次减 10 观察显存和速度。35B 在 40 最快,24B 在 30 最快。